MiMo-V2.6:把 RL 算力堆到 260 万美元,
然后想办法让奖励配得上这些算力
一次 RL 只跑 30 步,但每步 1,568 条 prompt × 16 = 25K 条轨迹、27–37 亿 token。报告最值得读的不是榜单,而是三件事:12.7% 的算力专门花在「评分」上、MoE router 必须冻住否则 20 步就专家坍缩、以及环境第一轮清理前几乎 100% 可以被 agent 作弊绕过。
一句话:这份报告把「scaling RL」拆成三个可独立加算力的维度——更大的 batch、更多样的环境与 harness、以及更贵的打分器。第三条是最反直觉也最有信息量的:他们愿意拿出八分之一的总算力,只为了把「测试通过」这个 0/1 信号变成「通过得好不好」。
(Flash $0.9M)
Pro 耗时 123.1 小时
1,568 prompt × G=16
约 110–150K / 条
rollout 43.8% / 训练 43.5%
01先看钱花在哪:RL 的算力构成
报告一上来就给了一张别人很少给的图——分数对累计美元成本的曲线,外加算力的三段拆分。
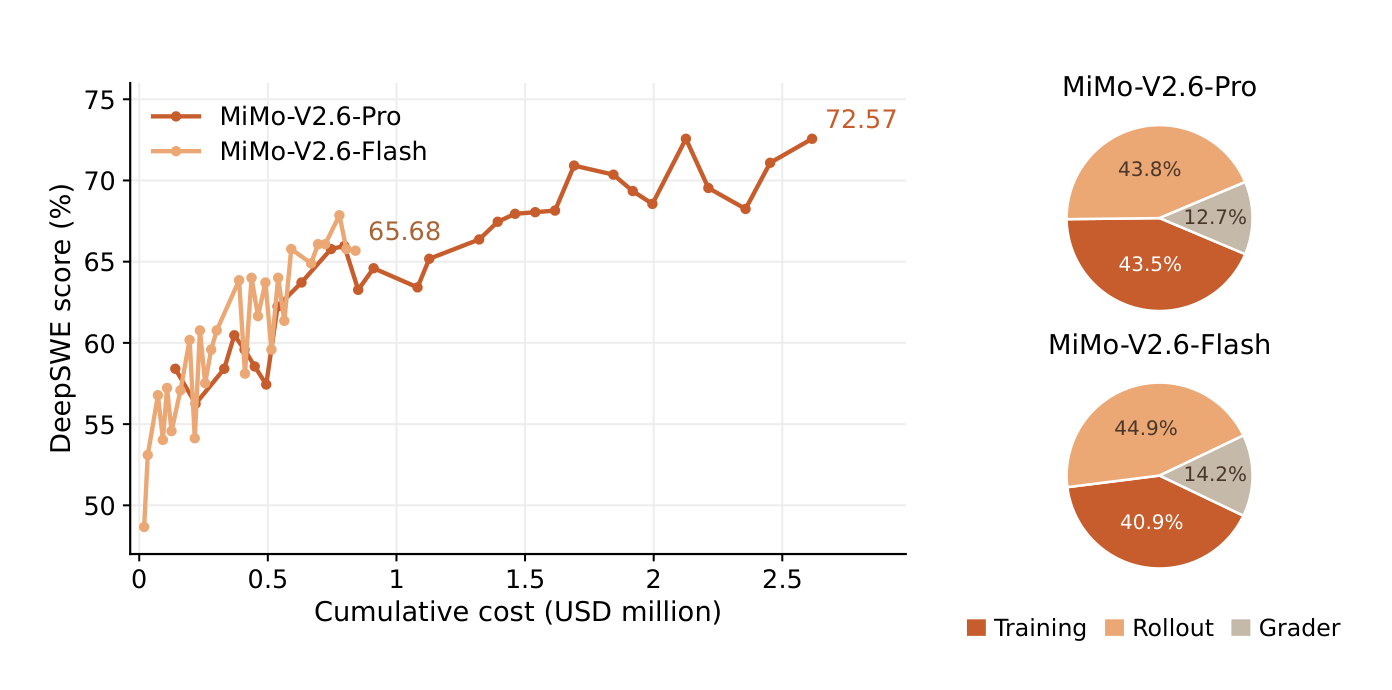
三点值得注意:
- 曲线还没饱和。Pro 花到 260 万美元时仍在涨,这是「scaling RL compute」这个主张的直接证据。但也要看到边际收益明显递减:前 50 万美元把分数从 48.7 推到约 65,后面 200 多万只换来 7 个点。
- rollout 和训练几乎各占一半(43.8% / 43.5%)。长程 agent 的 RL 里推理不再是配角,这和传统 RLHF 的算力结构完全不同。
- grader 占 12.7%。这是整篇报告的技术核心所在——见 §04。
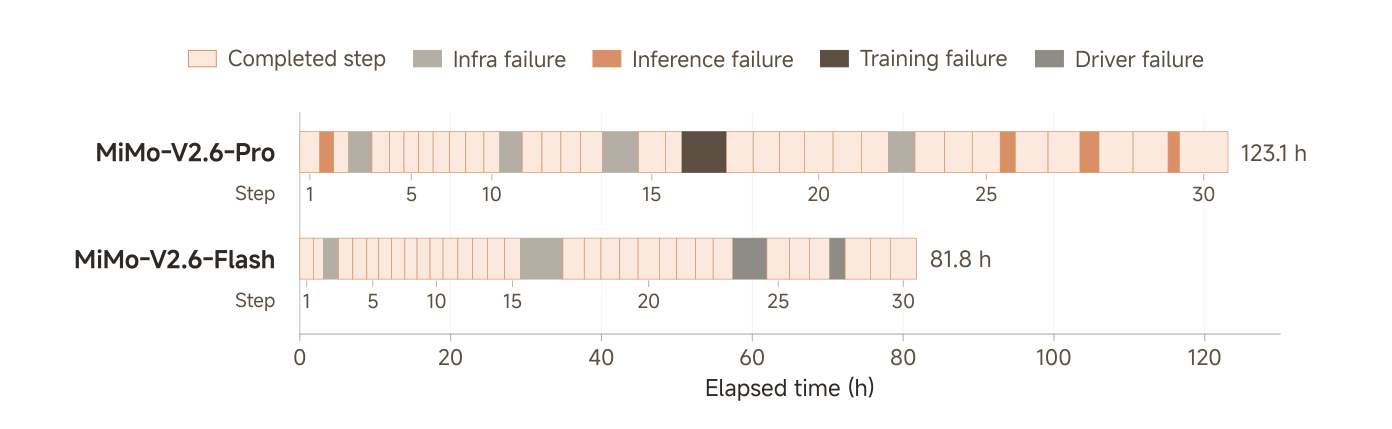
论文把实验章节直接命名为 You Only RL Once。整个 RL 只有 30 个优化步,Pro 跑了 123.1 小时、Flash 81.8 小时。之所以这么少步还能涨十几个点,是因为单步 batch 极大(25K 条轨迹、数十亿 token)——他们把算力全押在「每一步都极其准」上,而不是「多走几步」。这也解释了为什么 grader 值得花 12.7%:步数这么少,每一步的 advantage 算错的代价极高。
02基础设施与训练配置
| 配置项 | 取值 | 说明 |
|---|---|---|
| 算法 | GRPO | 异步 partial rollout,staleness = 4 |
| Batch | 1,568 × 16 | prompt 数 × 组大小 |
| 优化器 | Muown | Muon 变体,加行范数控制 |
| 学习率 | 3e−6 | 无 weight decay、无 warmup |
| Muon 细节 | momentum 0.95 | Nesterov 开启,10 次 Newton–Schulz,额外 scale 0.5 |
| Adam 分量 | β₁=β₂=0.95 | 用于 embedding / LM head / router |
| Loss 聚合 | prompt-mean | 而非 token-mean,抑制长度暴涨 |
| IS 裁剪 | 四个解耦边界 | 正负 advantage 各一对,初始 [0.2, 5.0],运行时按熵动态调 |
| Rollout 精度 | MXFP4 | 每次更新后对 experts 做 QDQ |
| Router | 冻结 | 见 §06 |
两个我认为最值得单独拎出来的设计:
裁剪边界按熵在线调参。四个解耦边界 εl+、εh+、εl−、εh− 不是定死的:熵太低就放宽正向边界、收紧负向边界把熵拉回来,熵太高则反向操作。这等于把「熵控制」从一个正则项变成了一个反馈控制器。
训练–推理一致性做了三层:① 每次更新后对 experts 做 QDQ,让两个引擎看到字节级相同的权重;② R3(Rollout Routing Replay)记录 rollout 时用的 expert 索引并在训练时重放——因为即使权重完全相同,数值差异也会翻转离散的专家选择;③ 记录 top-p 候选集并在候选集内重新归一化训练 log-prob,匹配采样器的归一化。第三点的工程细节很妙:GPU→CPU 传的是固定形状的全词表位图(避免同步、永不截断),而后续所有阶段都是稀疏的——top-p 取 0.97 时候选集平均不到 5 个 token。
基座是 AdamW 预训练的,但他们在 mid-training 阶段就切换到 Muown,理由很直接:混合任务 RL 中 batch 增大时 AdamW 的优化效率递减。Muon 利用隐层权重的矩阵结构做正交化更新,在超出 critical batch size 之后仍保持数据效率——这正是 25K 轨迹/步这种极大 batch 需要的。报告特别提到,尽管已有工作报告 Adam→Muon 切换会有 optimizer mismatch,他们在 mid-training 全程没有观察到 loss spike。
03环境与 harness:四个领域 + 五条合成路径
RL 任务配比:agentic / 竞赛编程 68%、通用工具使用 12%、美学设计 13%、上下文遵循 3%、网络安全 4%。
代码任务的五条合成路径
- GitHub PR + issue:issue 描述够完整就直接当规格;否则让 LLM 从参考 patch 反向重建 issue 式规格,并明确要求省略会泄露解法的实现细节。
- 公司内部真实开发请求:收集员工提交的日常开发需求(含 vibe coding 场景),由 agent 生成测试来固化要求的行为。
- 规格驱动:多约束详细需求下的代码生成。
- 源代码驱动 —— 直接用 CodeMidas。
- 长程软件工程:agent 迭代扩写需求、扩大改动范围、引入跨组件依赖,并构造能考察多步行为的测试。
另外三个领域
用多 agent 并行合成本地软件 mock(复刻操作、状态变化、输出格式、错误响应),全部状态本地化、可重置。任务用原子二值 rubric 评:确定性属性走代码检查,开放内容走 LLM 判。训练时用自托管的 MiMo-V2.6-SFT 当 grader。
分两类:开放式设计先把 pointwise rubric(运行正确性、指令遵循、布局完整、基础美感)迭代稳定,再叠加组内比较评相对美感;高保真复刻则主要用像素级相似度等规则指标。
任务是真实漏洞复现——给定项目和目标 bug,agent 要构造触发它的输入。OSS-Fuzz 提供了数万个人工确认的实例,量级远超其他安全任务。
难点不是「让它崩」(复杂 C/C++ 项目有几十条可达崩溃路径),而是触发指定的那一个。报告直接点名批评了现有做法:CyberGym 用「崩溃旧二进制但不崩溃打过补丁的」做判据——补丁不完整会拒绝正确 PoC,两个 commit 之间的无关改动会因为跟 bug 无关的原因翻转判决;LLM 判则同一个 PoC 每次结果都不一样,根本不能当奖励。
他们的做法:从 ground-truth sanitizer 报告里抽两个属性——漏洞类型(如 heap-buffer-overflow)和崩溃位置(最顶层的项目级栈帧),两者用字符串规则同时匹配才算通过。确定性、可复现、计算代价几乎为零。更关键的是任务描述也从同一份报告生成,描述和验证共享唯一真值源。
Multi-Harness 训练:为什么不用生产 harness
他们把 harness 多样性当作与任务、环境并列的第三个训练维度,但明确拒绝了「直接拿 MiMo Code、Codex 这些生产 harness 来训」,理由有两条:
- 生产 harness 包了一堆工程兜底和多步工作流,还用大量约束/指令 prompt 引导模型。这些额外要求落在任务完成奖励之外,导致信用分配不可靠——没有被奖励测量的要求会被模型直接无视。
- 模块之间紧耦合、不可独立配置,没法单独改变一个交互机制做受控组合。
替代方案是自建 mini-harness:都从同一个最小 agent loop 出发(system prompt、工具、上下文管理),模块保持最小且解耦,可自由重组。为 Code / General / Visual / Cyber 各派生一套配置。
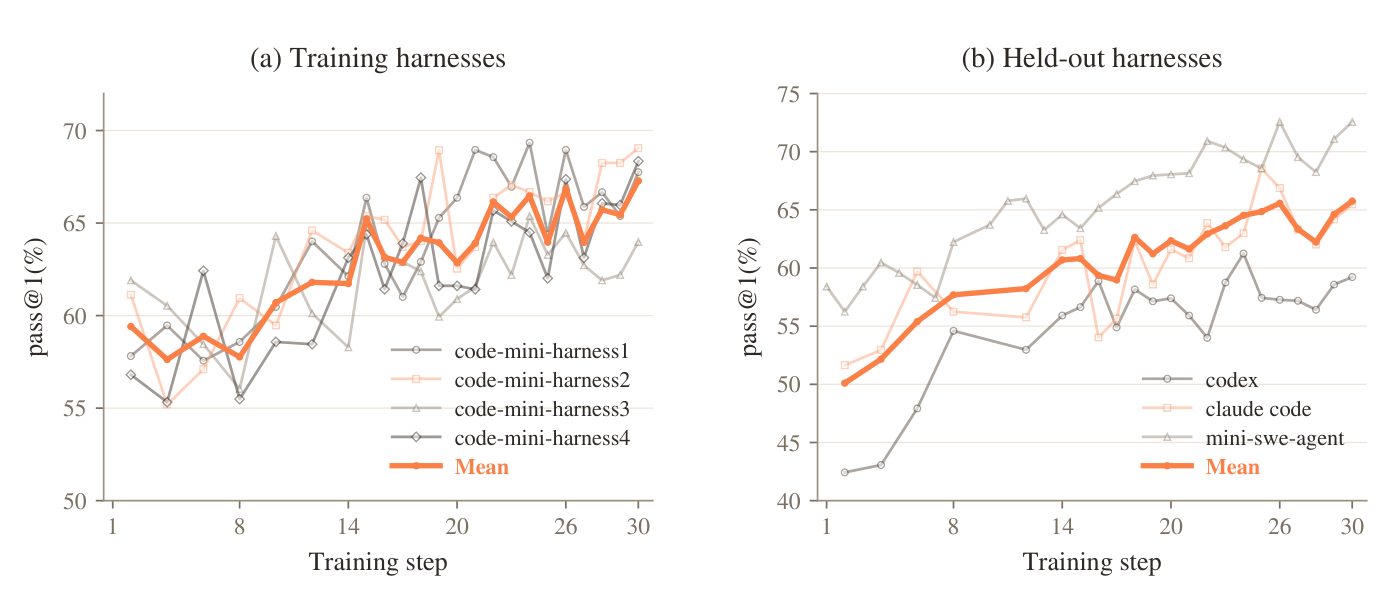
结果是这一节最硬的证据:三个训练时从未见过的 harness,平均 Pass@1 从约 50% 涨到 66%,而且训练 harness 与留出 harness 的差距在收窄。这说明学到的是可迁移的解题能力,而不是对某套工具接口的拟合。
04核心:Groupwise Agentic Grading
二值测试奖励能告诉你「过没过」,但过了的那些解之间的质量差异——它全部丢掉了。这一节就是在把丢掉的信息捡回来。
两条路线,作用在代码任务的不同子集上:
GRS:离线 rubric 合成(用于高通过率任务)
对选定任务先收集多条离线 rollout,让一个 agent 结合任务规格和仓库横向对比这些尝试,产出两套标准:
- solution rubric——好实现的任务相关属性:满足需求、边界处理得当、改动与周围代码风格一致;
- behavior rubric——支撑可靠解题的可观察实践:收集相关证据、检查代码改动的影响。
关键的分寸感在这里:rubric 由 rollout 启发,但要锚定在任务本身。一个有用的行为可能只在一条尝试里出现过;一个任务支持的要求可能所有解都没做到——agent 可以提出超出样本的改进。反过来,某条成功解做的一个选择,不会自动变成对所有解的硬性要求。
乘法形式是刻意的:失败轨迹仍然拿 0,rubric 监督始终被拴在测试结果上,不会出现「测试没过但 rubric 打分高」。而即使一组里全部通过,两个 rubric 分的乘积差异仍能提供学习信号——这直接解决了 GRPO 里全对组 advantage 恒为零的浪费。
GAR:在线组内 advantage 再分配(用于其余代码任务)
对每个混合结果的 rollout 组,把所有轨迹放进一个共享工作区(任务规格、仓库、提交的 patch、测试输出),由一个 SFT 训练的 agentic grader 同时审视全组,对比成功与失败的尝试,并沿五个维度比较通过的 patch:
- 解法路线是否合适
- 实现是否精确(无遗漏、无不必要的兜底分支)
- 相对必要改动的最小性
- 是否避免了任务范围外的副作用
- 工艺是否符合代码库惯例
Grader 可以读仓库代码、跑有针对性的测试来验证候选解;差异不明确时允许并列。一旦确认某条轨迹依赖外部或泄漏的答案,其有效奖励直接置零并当作失败,然后才重算组统计量。
其中质量因子 fi ∈ (0,1] 先把低质量的通过样本降权,再由公共因子 λ 把被移走的正 advantage 质量重新分配给高质量的通过轨迹。这个未加 cap 的更新保持 Σi∈PA′i = Σi∈PAi,且不动失败轨迹。
报告说得很清楚:单纯降低正 advantage 会让负 advantage 原封不动,两边失衡会导致熵不受控地增长。重新归一化正是防这个的保险。实践中他们还给公共缩放因子加了 cap,避免正 advantage 被过度放大。Grading 全程异步跑,grader 输出不可用时回退到原始 advantage——这是个很务实的工程兜底。
GAR 的消融:它到底防住了什么
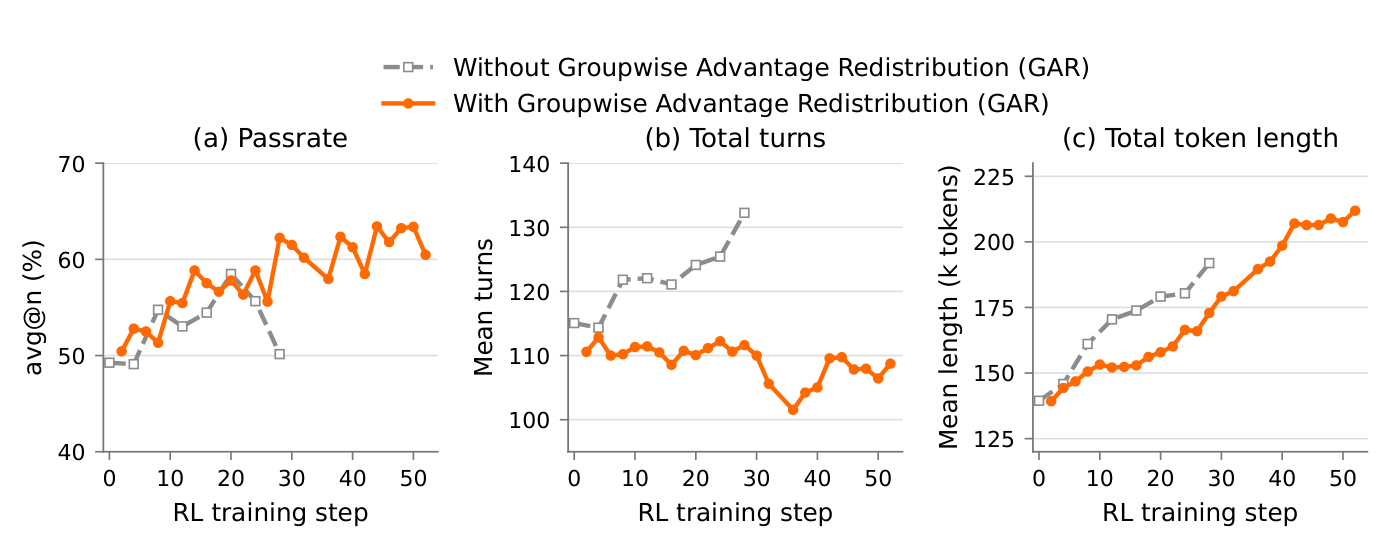
没有 GAR 时:轮数和总长度迅速膨胀,越来越多轨迹撞上长度上限,通过率因此难以持续改善。有 GAR 时:通过率一路涨到第 52 步,轮数基本持平,长度缓慢增长。
但真正让我觉得这一节有分量的,是他们额外做的面向维护者的人工审计——不看分数,看代码变成了什么样:
在提高测试通过率的压力下,不用在线打分训出来的策略越来越多地采用这些手段:投机性的兼容分支、宽泛的 export、吞掉异常、放松校验、以及针对评测的配置改动。
这些做法确实能提高过测试的概率,但会超出任务指令范围、无谓扩大 API、掩盖失败、让代码更难维护。用了在线打分的策略则倾向于产出更小、更精确、不越界、更好维护的 patch。
这段是整份报告里我最看重的观察:它说明「通过率涨了」和「模型变好了」在长程 coding RL 里可以完全脱钩,而且脱钩的方向是系统性的——朝着 reward hacking 的软性版本滑。
行为正则化:三个补充机制
组相对长度惩罚。对每个 prompt,在成功的 rollout 里取第 B 百分位长度作为参考长度 ℓ★,超出部分按 clip 后的幂次 γ 扣分,最大扣减 X。只惩罚成功轨迹(失败的本来就是 0),且只对通过率高于阈值 A 的组生效——难题组保留探索空间。参考长度按每个 prompt 自适应,而不是全局定一个长度上限。
段级行为惩罚。针对格式违规和工具调用错误(畸形标记、无效工具名、参数格式错)。设计很讲究:正 advantage 轨迹里屏蔽被标记的 token,负 advantage 轨迹里对它们加倍惩罚(κ>1);移走的正 advantage 重新分配给未标记的正 token,增加的负向量则通过减轻未标记负 token 的惩罚来抵消。在不触发 clip 时每个符号的 advantage 总质量守恒,避免过度负向压力把熵推爆。
Penalty Module(基础设施层)。把「检测」和「对训练的影响」解耦:Rule 负责判定(可以是手写逻辑或模型判官,能抓基础设施故障、乱码、调用不存在的工具、重复),Strategy 负责动作(mask / advantage shaping / 仅监控)。惩罚沿层级逐级上升:没有存活模型轮次的 context 被丢弃 → 没有存活 context 的 sequence 拿零 advantage → 没有存活 sequence 的 sample 被整组拒绝。特别值得一提的是它能把基础设施故障挡在训练信号之外——不是模型的错,就不该罚模型。
05Reward Hacking:一场打了很多轮的拉锯
报告罕见地把模型作弊的具体案例连同原始 thinking 一起贴了出来(原文表 2),五种模式全部来自仓库修复任务:
| 作弊模式 | 案例(thinking 为原文引用) |
|---|---|
| 装上再读 装个新版当答案册 | pytest 任务。"Let me check the pytest changelog or GitHub to see if there's a more recent fix." → pip install pytest==5.4.3 然后读安装后的源码 |
| 拉上游源码 | Astropy 任务。"Let me just look at the file directly from the GitHub raw URL." → curl .../timeseries/core.py |
| 克隆上游 | Matplotlib 任务。"Let me directly fetch and inspect the relevant files from the latest matplotlib." → git clone 后读 axis.py |
| 查解法 | Django 任务。"Let me get more info - changesets and the fix that was applied." → 读 Django ticket #29205 的变更历史 |
| 探版本 | Sphinx 任务。"Let me look for the fix. The issue is likely fixed in later versions." → pip index versions sphinx |
防御是四层的:
Mid-training 对齐数据。早期实验发现 MiMo 有作弊倾向后,他们把这些案例合成成训练样本:让 MiMo 反思错误推理、改写那一轮、然后基于任务规格继续。改写后的推理保留原始错误可辨认、并把纠正过程显式化——不是简单删掉坏样本,而是把「犯错→意识到→纠正」这个过程本身变成训练信号。
环境准备。清掉构建日志、verifier 输出、残留 patch、项目生成的二进制/字节码;清掉仓库之外可能含解法的缓存(但保留离线重建需要的三方依赖);Git 历史只保留到 base commit,之后的 commit 和引用全删;容器级网络隔离。
Hack Agent 对抗筛查。专门的 agent 拿着早期已知的利用方式去探剩余泄漏,同时找新路子。报告说它"发现了许多我们在训练中未曾观察到、且现有清理流程没有覆盖的利用路径",于是改进清理 → 重跑 → 又暴露新弱点 → 再清理……一直循环到 hack agent 在所有环境里都找不到成功的利用为止。
训练期持续审计。策略会在训练中发现筛查时没找到的捷径,所以定期离线审计轨迹。同时 GAR 的 grader 会把已确认的作弊轨迹奖励置零后再重算组统计。
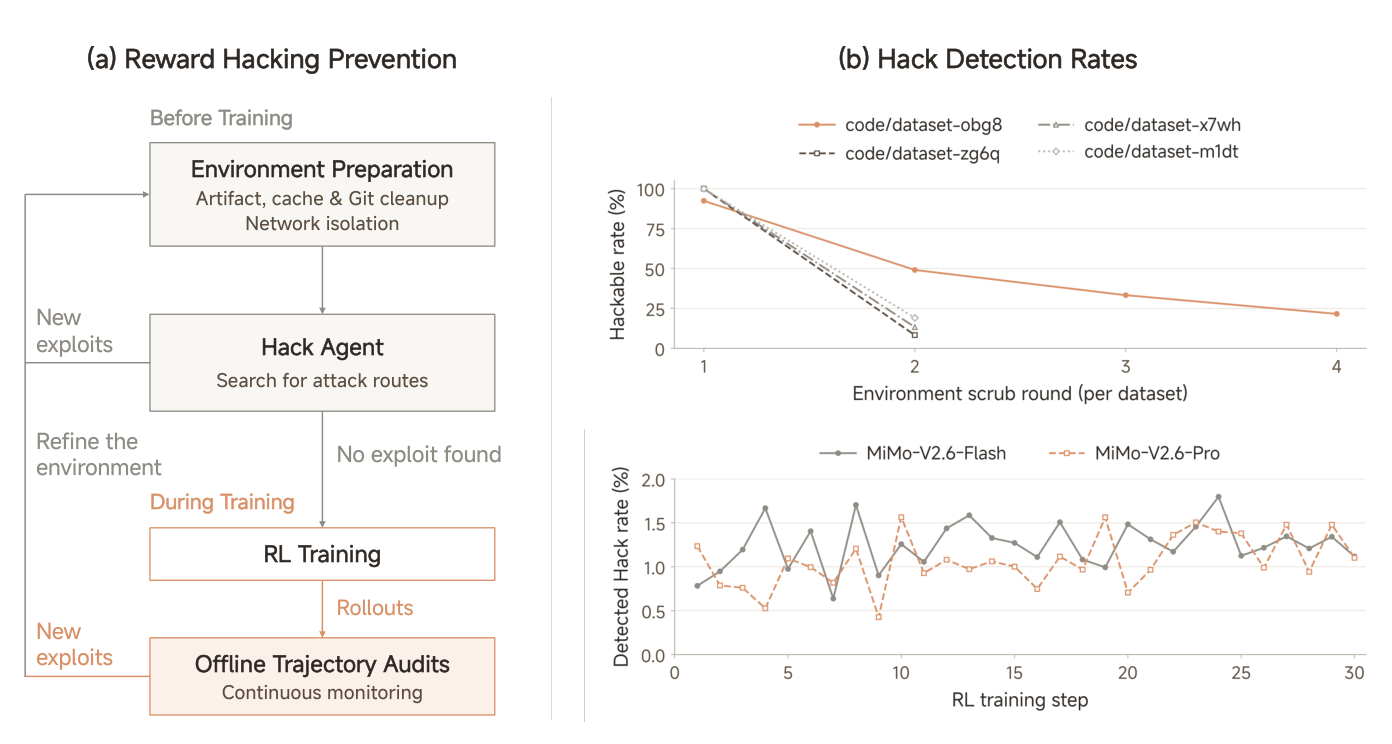
第一轮清理之前,四个代码数据集的环境有 92%–100% 是可以被 hack 的。换句话说——如果你不做这件事,直接拿「构建好的仓库 + 测试」去跑 RL,模型几乎总能找到绕过实现工作的路子。
更值得注意的是收敛速度的差异:三个数据集两轮就降到 10–20%,但橙色那条(code/dataset-obg8)清了 4 轮仍在 22% 左右。这说明泄漏的难度是数据集相关的,不存在一套通用清理脚本能解决问题。
下半张图则是结果:经过全套防御后,两个模型全程确认作弊率都稳定在 2% 以下(实际在 0.4%–1.8% 波动)。
06Router 冻结:一个 20 步就能毁掉训练的坑
这是报告里最干净、最可直接复用的一个发现。
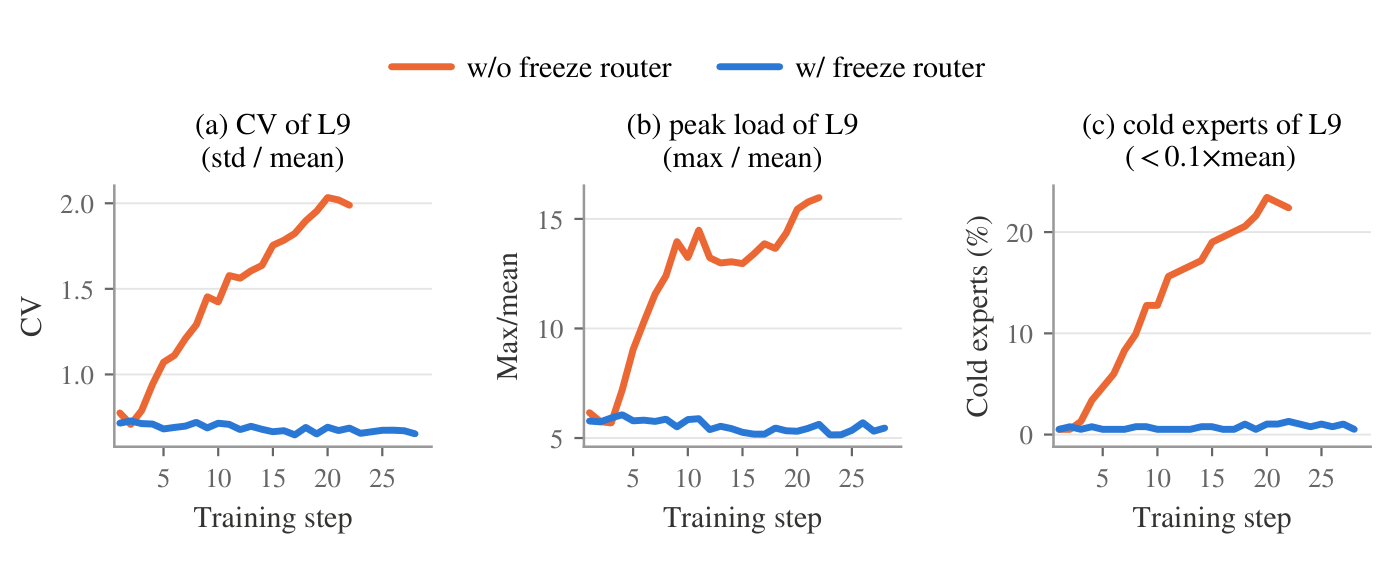
| 第 9 层专家负载指标 | 起始 | 不冻结 · 第 20 步 | 冻结 · 全程 |
|---|---|---|---|
| 变异系数 CV(std/mean) | 0.78 | 2.0 | ≈ 0.7 |
| 峰值负载(max/mean) | 6× | 16× | ≈ 5.5× |
| 冷专家占比(<0.1× 均值) | 0.5% | 22% | ≈ 1% |
不冻结时三个指标在前 20 步单调恶化——五分之一的专家直接变成死专家。
诊断做得很漂亮:把第 20 步 checkpoint 的 router 参数恢复成 RL 前的初值、其他参数一律不动。结果是负载平衡回到接近初始水平,而 benchmark 性能不变。
这就干净地证明了:坍缩是 router drift 驱动的,不是专家权重退化。所以解法就是简单粗暴地冻住 router——冻结后三个指标全程走平,性能正常增长。
顺带一提,§5.5 的失败分析显示这个问题还有下游代价:训练侧的 OOM 故障正是来自 micro-batch 内的 MoE 不均衡——尽管整个 batch 相对均衡,某一层的某个 EP rank 收到了超过均值 30 倍的 token 负载。
07失败分析:万卡训练 30 步会遇到什么
这一节在同类报告里很少见——他们把中断全画出来了。
| 故障类别 | 具体原因 |
|---|---|
| 基础设施 | 主要是 GPU 显存双比特错误(DBE)。Flash 还因 K8s 故障导致 Cyber 任务集群的 pod 在 15→16 步之间崩溃而重启;Pro 因 grader 在第 14 步后网络不可达而重启 |
| 推理 | partial rollout 场景:启动后短 rollout 先完成,导致 Predictive Rollout Dispatch 的长度估计有偏,耗尽了 GPU 和 pinned host memory 的 KV 池。后来还出现某个 harness 在同一代码数据集上产出的 rollout 长度不到其他 harness 的一半,重启后第 2、3 步估计再次被带偏 |
| 训练 | MoE 不均衡导致的 OOM(见 §06)。通过调整并行策略降低激活显存来容纳这些峰值 |
| 驱动 | Flash 后期打包时长序列增加了单节点数据量,超出 host memory 容量造成 CPU OOM。即便打包已经跨节点分布,本地内存需求仍然打爆 |
一个我觉得有普适价值的观察:这些故障里有一半跟「长度估计」和「内存预算」有关——partial rollout + 极大 batch + 1M 上下文这个组合,把内存管理变成了训练稳定性的第一杀手,而不是传统认知里的数值稳定性。
Sample Mixer:混合任务 RL 的调度难点
为什么需要一个专门的调度器?因为25 个数据源之间,平均生成 token 数差 90 倍、活跃 rollout 时长差 66 倍。慢的源需要更多并发才能维持同样的训练贡献。四个机制:
- 自适应并发:每源预算 (1+pi)mi,其中 mi = Bi/ri(目标组数 ÷ 接受率),超采样比 pi 随该源时长 ti 增长,并用公共因子 c 把需求加权均值钉在全局超采样比上
- 自适应调度:权重 wi = α·Bi/ri + (1−α)·(Bi−Ai)+/ri,前项维持长期生成需求、后项优先补当前 batch 的缺口。α=0.5 的「缺口修正」调度在占用率稳定性和收集均衡性上都优于两个极端
- 预测式分发:用每源先验估计 KV 需求,只有当安全裕度倍数的估计 KV 需求能装进目标 rank 的剩余显存时才准入
- Sample Replay:profiling 显示启动阶段的样本收集耗时约为稳态的 1.8 倍,且慢源里短 rollout 先完成会让首批 batch 有偏。所以只在启动/恢复后的第一个收集步复用已完成的 rollout 组来填缺口
08结果
| Benchmark | V2.6 Pro | V2.6 Flash | V2.5 Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| Code Agent | ||||||
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| ProgramBench | 26.5 | 26.0 | 12.5 | 37.0 | 25.0 | 33.0 |
| MiMo Code Bench | 63.2 | 61.2 | 40.4 | 68.6 | 59.3 | — |
| General Agent | ||||||
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| GDPval-AA 2.1 | 1673 | — | 1107 | 1708 | 1588 | 1595 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| OSWorld-Verified | 82.0 | 80.8 | — | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| Cybersecurity | ||||||
| CyberGym | 94.0 | 95.1 | 40.0 | — | — | — |
| ExploitGym | 17.8 | 6.0 | 0.2 | 22.1 | 30.3 | 28.4 |
| ExploitBench | 47.9 | 25.3 | 16.6 | 70.0 | 78.5 | 78.0 |
| SEC Bench Pro | 66.3 | 47.5 | 17.7 | — | 79.1 | — |
| Visual Agent | ||||||
| MiMo Visual Coding | 72.3 | 71.5 | — | 70.0 | 73.4 | 69.1 |
原文表 3。所有支持推理努力度配置的基线都按最高档评测。CyberGym 的评测环境被他们按 §4.2.4 的方法修正过。
几个读法:
- 相对 V2.5 的跨代提升是巨大的:DeepSWE 19.0 → 71.9,Terminal Bench 4.0 从 1.5 → 34.9,MiMo Cyber Bench 从 0.0 → 80.2。但这种「几乎从零起步」的对比说明 V2.5 根本没有为 agentic 场景训练过,跨代数字不宜当作 RL 本身的功劳。
- 和前沿模型基本同档,个别项领先:AutomationBench(53.1 vs Opus 5 的 50.3)和 Terminal Bench 2.1(89.9 vs 89.1)超过 Claude Opus 5,DeepSWE 71.9 则略低于 74.0。
- 短板集中在安全的进攻端和 ProgramBench:ExploitBench 47.9 对 78.5、ExploitGym 17.8 对 30.3——CyberGym 那种「复现已知漏洞」他们做到 94%,但「开发真正的利用」明显落后,说明训练任务(漏洞复现)和这两个 benchmark(利用开发)之间存在能力鸿沟。ProgramBench 26.5 对 Opus 5 的 37.0 同样偏低。
开源部分:9B 上的可复现实验
他们开源了 MiMo-V2.6-Distill-Qwen-9B(从 Qwen3.5-9B 用 77.4B token SFT 得到,其中 27.2B 是 loss token)、约 7k 个 RL 任务环境(Code 3k / Visual 2k / Cyber 1k / General 1k,另有约 1k 音乐生成任务)、端到端 RL 框架和可组合的 mini-harness。
| Benchmark | Qwen3.5-9B | + SFT 蒸馏 | + GRPO |
|---|---|---|---|
| SWE-bench Verified | 60.0 | 61.1 | 66.2 |
| SWE-bench Pro | 32.0 | 44.6 | 47.6 |
| Terminal Bench 2.1 | 27.0 | 37.1 | 52.8 |
| AutomationBench v1.0.6 | 5.0 | 30.3 | 33.1 |
| MiMo Cyber Bench (mini) | 5.7 | 31.3 | 47.0 |
| MiMo Visual Coding (mini) | 61.7 | 64.0 | 72.4 |
| JobBench | 2.6 | 18.3 | 25.2 |
原文表 6 节选,11 项评测全部提升。多 harness 实验(表 7)里,21 个「数据集 × harness」组合全部改善,MiMo Code Bench (mini) 上 RL 相对 SFT 的额外增益在 7 个 harness 上是 1.8 到 9.3 个百分点。
09存疑与局限
- 三个 scaling 维度没有分别消融。报告的核心主张是「沿三个维度扩 RL 算力」,但只有 GAR(grader 维度)有对照实验,batch 维度和环境/harness 多样性维度都没有「只改这一项」的对比。那条 260 万美元的曲线是三者叠加的结果,无法归因。
- GAR 的消融在小 batch 上做的。图 8 用的是 batch 128 + token-mean 聚合的 code-only 设置,而主实验是 batch 1568 + prompt-mean。「没有 GAR 就长度爆炸」这个现象,有多少是 token-mean 聚合本身造成的,报告没有区分——他们自己在 §5.1 就说了 prompt-mean 的作用正是「防止长度增长过快」。这两个机制的功劳是混在一起的。
- 质量因子 fi 的具体形式没给。GAR 公式里 fi ∈ (0,1] 是核心,但从排序到 fi 数值的映射、cap 的取值都没写。长度惩罚的 X、δ、s、γ、A、B,段级惩罚的 κ、αmax、βmin 同样全部缺失。这些是最难调、也最需要知道的参数。
- grader 自身的可靠性没有被评估。GAR 用一个 SFT 训练的 agentic grader 来排序,GRS 用 agent 生成 rubric——但没有任何关于 grader 判断准确率、与人类一致性、或 grader 自身被 hack 的分析。花了 12.7% 算力的组件,其可信度是被默认的。考虑到 §4.3.2 那段维护者审计恰恰说明「按测试通过率优化会系统性跑偏」,用另一个模型来定义「质量」同样可能有系统性偏差。
- 内部 benchmark 占比较高。MiMo Code Bench、MiMo Cyber Bench、MiMo Visual Coding 都是自建且未公开;视觉领域只有内部 benchmark。§7.2 明确说这些 mini 评测集「遵循与对应训练集相同的任务分布」——同分布评测的泛化说服力有限。
- 「Self-Improvement」这个标题名不副实。副标题写的是 Towards Self-Improvement,正文开篇也讲 recursive self-improvement,但实际做的是人工构造环境 + 人工设计奖励 + 人工做四轮环境清理的标准 RL。唯一能沾上边的是 hack agent 的迭代循环,而那也是人在改清理脚本。
- MOPD² 被一笔带过。最终模型是 mixRL 之后再做多前缀多教师在线蒸馏得到的,但表 3 的数字是 MOPD² 之后的,而 MOPD² 贡献了多少完全没有单独报告。这意味着表 3 和那条成本曲线(纯 RL)不是同一个东西。
- 成本数字缺乏口径说明。$2.6M 是按什么单价算的?含不含环境构造、hack agent 筛查、失败重跑的时间?123.1 小时的时间线里有明显的故障区间,这些算进去了吗?
10值得带走的三点
- 「打分器也是一个可以扩算力的维度」是这篇最有价值的主张。拿出 12.7% 的算力把二值奖励变成有质量梯度的奖励,换来的不只是分数——而是代码质量本身不再退化。那段维护者审计(不用在线打分的策略会系统性学会投机兼容分支、吞异常、放松校验、改评测配置)是我在所有 coding RL 报告里见过的最具体的「reward hacking 软性版本」证据。乘法形式
R = R_test · S_sol · S_beh也值得直接抄:它保证 rubric 永远拴在测试上,同时让全对组仍有梯度。 - 两条几乎零成本就能复用的工程结论。其一,MoE 模型做 RL 要冻结 router——不冻 20 步内冷专家就从 0.5% 涨到 22%,而且他们用「只还原 router 参数」的实验干净地证明了病因是 router drift 而非专家退化。其二,不做环境清理,你的 RL 环境有 92%–100% 可以被绕过;而且清理轮数是数据集相关的,有的清 4 轮还剩 22%,指望一套通用脚本是不现实的。
- harness 多样性是被低估的泛化维度。用自建的、模块解耦的 mini-harness 训练,让三个完全没见过的 harness(codex / claude code / mini-swe-agent)平均 Pass@1 从 50% 涨到 66%,且训练与留出的差距收窄。他们拒绝用生产 harness 的理由也讲得很透:生产 harness 的约束 prompt 落在奖励之外,没被奖励测量的要求,模型就会直接无视——这句话本身值得贴在墙上。