CodeMidas:不要 issue,不要 commit,不要测试
——直接把源代码点成 RL 环境
已实现的功能本身就同时提供了「任务定义」「参考解」和「可执行验证器」三件套。CodeMidas 用 agent 流水线把 3,185 个开源仓库翻译成 5,545 个可验证训练任务,在 MiMo-V2.5 上跑 GRPO,五个外部 benchmark 全涨。
一句话:过去做 coding RL 数据,大家都在挖「开发记录」(issue / PR / commit / 已有测试 / 文档);CodeMidas 说这些记录只是代码的影子,直接从代码本身反推任务,供给量和语言覆盖都上一个台阶。
01问题:环境供给被「开发记录的覆盖率」卡住了
Agentic coding 的 RL 需要两样东西:多样的任务(支撑泛化)和可靠的奖励(保证强化的是对的行为)。真正的瓶颈从来不是 GRPO 怎么写,而是——上哪儿去弄几千个带可信验证器的真实软件任务。
现有 pipeline 基本分三派,但都有一个共同的结构性限制:任务的产生依赖于某种已被人工记录下来的东西。
- 挖开发记录派:SWE-bench / SWE-rebench V2 / R2E-Gym / daVinci-Env,从 issue、PR、commit 里提取任务陈述与 fail-to-pass 测试。→ 任务量 = 仓库里被记录下来的变更量。
- 围绕已有测试派:SWE-smith 合成能打破现有测试的 bug,SWE-Flow 从单测及其运行时依赖倒推增量开发任务,SWE-Hub 把测试验证过的 bug 合成与仓库构建结合。→ 任务量 = 仓库的测试覆盖率。
- 吃文档派:R2E 把 docstring 精炼成规格,MindForge 用文档 + 编译好的参考程序做 from-scratch 实现。→ 任务量 = 文档写得好不好。
而代码库里绝大多数已实现的功能,既没有对应的 issue,也没有对应的测试,更没有像样的文档。这部分才是真正的大头,却一直没被用起来。
| 方法 | 无需 issue | 无需 PR | 无需 commit | 无需已有测试 | 无需文字描述 | 语言数 |
|---|---|---|---|---|---|---|
| SWE-rebench V2 | ◆ | ✗ | ✗ | ✗ | ✓ | 20 |
| daVinci-Env | ✗ | ✗ | ✗ | ✗ | ✓ | 1 |
| R2E-Gym | ✓ | ✓ | ✗ | ◆ | ✓ | 1 |
| SWE-smith | ✓ | ◆ | ◆ | ✗ | ✓ | 1 |
| SWE-Flow | ✓ | ✓ | ✓ | ✗ | ✓ | 1 |
| SWE-Hub | ✓ | ✓ | ✓ | ✗ | ◆ | 11 |
| R2E | ✓ | ✓ | ✓ | ✓ | ✗ | 1 |
| MindForge | ✓ | ✓ | ✓ | ✓ | ✗ | 15 |
| CodeMidas | ✓ | ✓ | ✓ | ✓ | ✓ | 23 |
原文表 1。✓ = 不需要;◆ = 流水线的一部分需要;✗ = 必须有。最右列的语言数差异很说明问题:依赖 AST/测试框架特化的方法基本锁死在 Python,只吃源代码的方法可以摊到 23 种语言。
02核心洞察:一段已实现的功能自带三件套
这篇论文的全部立论建立在一个很朴素的观察上——一段已经写好、能跑的功能代码,同时是任务、是答案、也是判卷标准:
它的 public 接口和可观察行为,定义了「一个 agent 应该实现什么」。把核心实现删掉,剩下的代码库就是开发起点。
被删掉的那段原始实现本身就是 reference solution,单独留存,不进 solver 环境。
测试的期望值不靠模型猜,而是靠执行原始代码得到(execution-grounded)。构造 agent 在一份 reference 副本上调用 public 入口、喂入构造好的输入、记录真实输出,再把这个输出写成断言。于是「正确」有了一个可执行的定义,而不是一个 LLM 的意见。
每个任务最终是一个三元组:任务陈述 + 容器化开发环境 + 隐藏的可执行验证器。验证器全程不在 solver 的环境里,只在 grading 时注入,返回 0/1 二值奖励给 RL。
任务陈述必须把要求的行为说清楚(否则 agent 不可能猜到),同时必须把内部实现留给 agent 自由发挥(否则就成了抄写)。对应到测试上就是:既要能拒绝错误实现,又要能接受和 reference 不一样但同样正确的实现。§03 的大部分工程量,都是在处理这对矛盾。
03方法:四段式 agent 流水线
CodeMidas 的特点是每一个环节都花 agentic compute——不是写规则脚本,而是让 agent 去探索、去构造、去审查、去对抗。
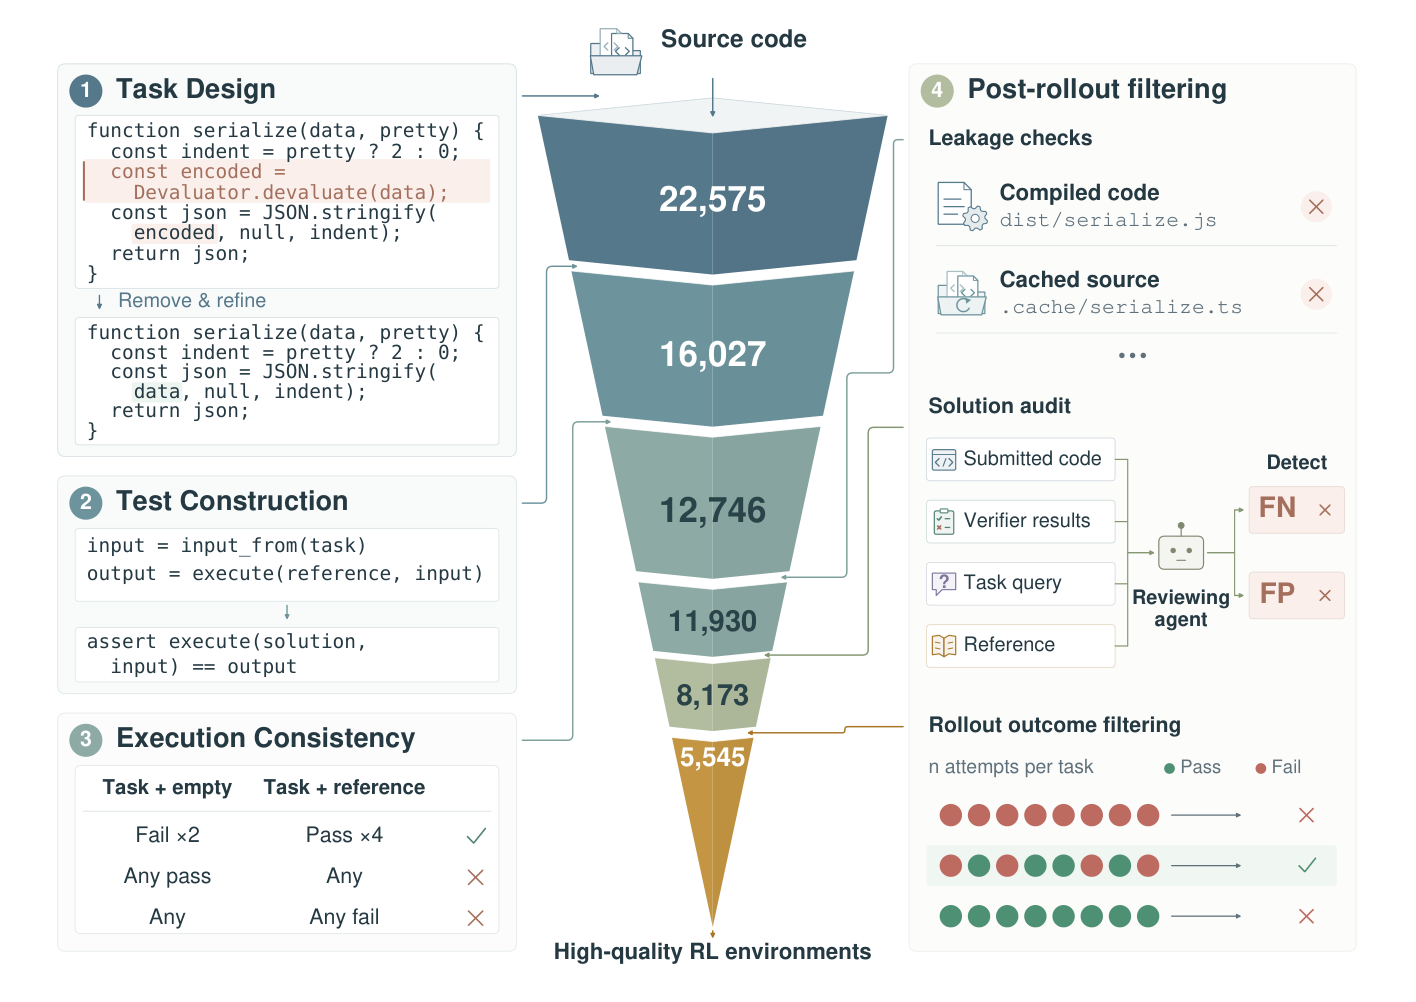
3.1 任务设计与代码库改造
Agent 先检查代码库结构和构建元数据,找有 public 入口、有可观察结果的功能。可用的接口形态有三类:命令行工具(看进程输出)、纯函数(看返回值)、有状态的库 API(看多次调用之间的状态变化)。论文明确说优先选需要跨代码库推理的任务,不是挑单个孤立函数。
对每个候选,agent 追踪 public 入口和共享依赖来划定任务边界,然后删掉选中的核心实现,再调整剩余代码,让它成为一个自洽的开发起点(比如图 1 里 Devaluator.devaluate 被移除后,serialize 剩下的部分要能编译)。
任务陈述和代码边界是一起改的,不是先删代码再写描述。共享组件和项目上下文要保留。最终陈述定义的是:输入、可观察行为、必须提供的 public 接口——内部 helper 和算法选择完全放开。
3.2 执行驱动的测试构造
Agent 把陈述里的行为要求映射成测试输入和边界用例,在 reference 副本上执行并记录结果。三类接口对应三种测试形态:CLI 用命令执行,纯函数用输入输出对,有状态 API 用调用序列(会覆盖调用顺序和清理行为)。每个测试都记录它覆盖了哪条要求。
测试写完后,另一个 agent 逐条审查每个断言,找出陈述并不支持的限制——精确的措辞、无意义的顺序依赖、对内部结构的检查——并把它们替换成行为层面的检查。如果某条断言依赖私有符号且找不到行为替代,整个任务直接拒绝。改完的测试要在 reference 上重跑一遍确认仍然通过。
这一步针对的就是 EvalPlus / PatchDiff / SWE-bench Pro 反复指出的老问题:测试过严会把正确的替代实现判成错,在 RL 里这等于持续给出错误的负奖励。
3.3 环境准备与执行一致性
从统一的基础镜像出发,agent 按项目自身的依赖声明安装依赖、准备构建与运行时资源。然后做清理——这一步决定了任务会不会被白嫖:
- 编译产物(
dist/serialize.js这类) - 缓存副本(
.cache/serialize.ts) - 构造 agent 自己留下的文件
- 与目标功能相关的原有测试
然后是六容器一致性检查,我认为这是整条流水线里性价比最高的一道闸:
它一次性筛掉两类问题:fail-to-pass 转换不成立(任务其实已经被解决了,或参考解在该环境下跑不通)和执行不稳定(flaky test、时序依赖、随机性)。4 次重复跑参考解就是专门冲着 flakiness 去的。
3.4 Post-rollout 过滤:用真实 rollout 反查环境缺陷
上面的检查只覆盖了「起始代码库」和「参考解」两个极端。真正会暴露问题的是中间地带——agent 实际写出来的那些半对不对的实现。所以在正式 RL 之前,还有三道基于 rollout 的过滤:
泄漏过滤(对抗 rollout)。一个 agent 被明确要求去作弊:不做真正的开发工作,只在 solver 可见的整个环境里搜刮——编译产物、缓存、构造 agent 的残留文件、已安装的目标项目副本——试图把答案捞出来。它记录支撑每个可疑利用点的命令和输出,再由另一个 review 环节对照参考解和验证器核验证据。确认能绕过实现工作的,任务作废。
解答审计(查验证器自身的 FP/FN)。让一个 coding agent 对每个任务尝试 4 次,然后 reviewing agent 拿着任务陈述、验证器、参考解,去看这些 rollout 的提交代码和测试输出,判断每个实现到底满不满足陈述,再和验证器的判决对比:判错却通过 = 假阳性,判对却失败 = 假阴性。有验证器缺陷的任务全部拒绝。
Rollout 结果过滤。用一个 frontier model 对每个任务多次尝试,只保留「有成功也有失败」的任务。全对或全错的原因可能是难度极端,也可能是测试太弱、陈述缺要求——论文诚实地说了:这些结果本身并不告诉你是哪一种,所以一律丢掉。这同时起到了难度过滤和残余缺陷探测的双重作用,而且在 GRPO 下还有额外好处:全对全错的任务组内 advantage 恒为 0,本来就是白烧算力。
漏斗:从 22,575 到 5,545
数值取自原文图 1 的金字塔(论文只说「各阶段保留的任务数」,阶段与数字的对应按流水线顺序推定)。总留存率 24.6%,四分之三的候选被扔掉;其中 8,173 这一档正是 §06 消融里那个「vanilla 8k」。值得注意的是最后两道基于 rollout 的过滤合计砍掉了一半以上——说明静态检查远远不够。
04数据集画像:不是玩具任务
最终得到 5,545 个任务 / 3,185 个开源仓库 / 23 种语言 / 15 个技术领域。
原文图 2。Top-10 覆盖 5,445 / 5,545(98.2%),尾部还有 13 种语言。对比 SWE-bench 系几乎全是 Python,这里 Python 只占五分之一,TypeScript + Go + C++ + JS 加起来 58%。
原文图 3。另有 0.3% 的任务未标注领域。前三大领域(Systems / Web / Dev Tools)合计 45.6%。
统计参考 patch 中新增和删除的全部源代码行(含注释与空行):中位数 142 行,四分位距 66–305 行,并且 65.9% 的任务参考 patch 至少涉及两个源文件。这个量级说明它既不是 HumanEval 式的单函数补全,也不是 SWE-bench 那种平均几十行的 bug 修复,而是模块级的功能实现。
05训练配置与主结果
初始策略是 MiMo-V2.5,算法 GRPO,奖励就是验证器的 0/1。关键超参(附录 A):
| 配置项 | 取值 | 备注 |
|---|---|---|
| Batch size | 32 | 每步 32 个任务 |
| 每任务 rollout 数 | 32 | 即每步 1,024 条轨迹 |
| 最大 prompt 长度 | 8,192 | 任务陈述很短 |
| 最大 response 长度 | 516,096 | ≈ 504K token,长程 agent 的本体 |
| 每条 rollout 最大轮数 | 500 | 工具调用轮次 |
| 最大 staleness | 8 | 异步训练,容忍 8 步陈旧 |
| Advantage 标准差归一化 | 关闭 | 避免低方差组被放大 |
| 优化器 / lr | Adam / 5e−6 | warmup 0,weight decay 0 |
| Adam (β₁, β₂) / ε | (0.95, 0.95) / 1e−15 | β₂ 异常小 |
| 梯度裁剪 | 1 | — |
8,192 : 516,096 这个 1:63 的 prompt / response 比例,是这类长程 agentic RL 最直观的特征——输入是一句话需求,输出是几十万 token 的探索、编辑与验证过程。max staleness = 8 说明训练是异步的。关闭 std 归一化、β₂ = 0.95 这两项与近期多篇长程 RL 工作的选择一致。
五个外部 benchmark 全涨
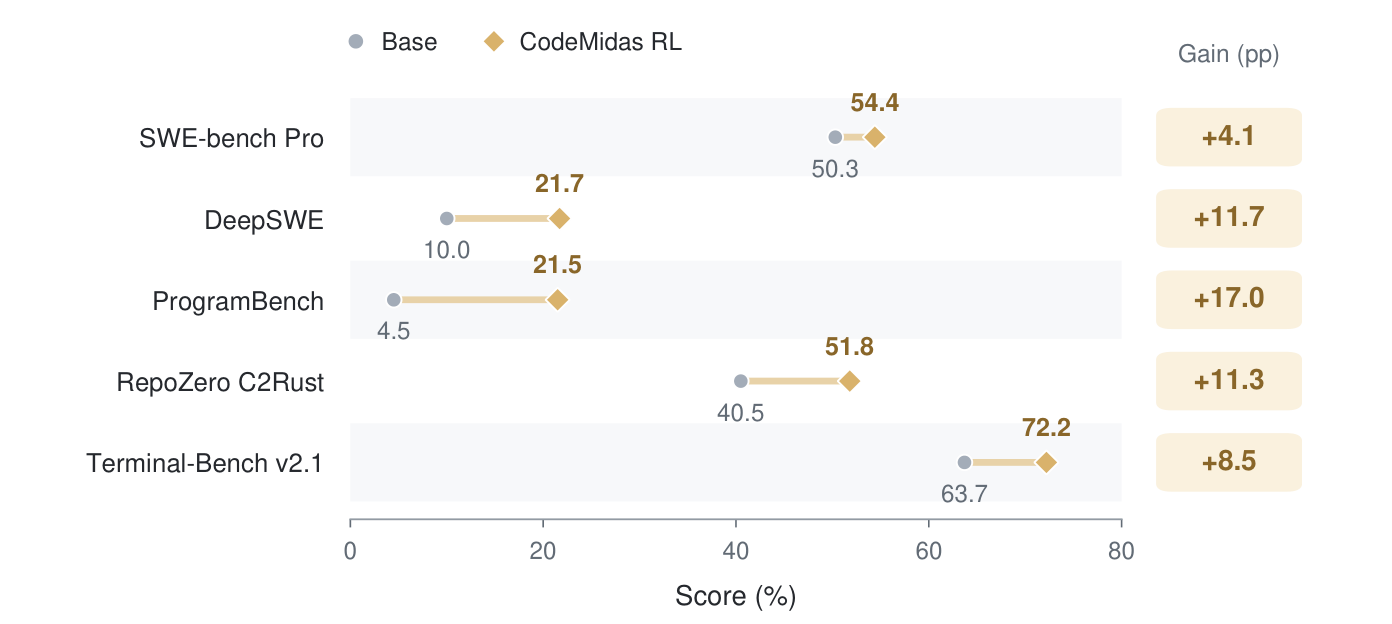
| 评测 | 任务类型 | Base | CodeMidas RL | 增益 (pp) |
|---|---|---|---|---|
| SWE-bench Pro | 长程 issue 修复 | 50.3 | 54.4 | +4.1 |
| DeepSWE v1.1 | issue 修复 | 10.0 | 21.7 | +11.7 |
| ProgramBench | 整程序从零构建 | 4.5 | 21.5 | +17.0 |
| RepoZero C2Rust | C → Rust 代码翻译 | 40.5 | 51.8 | +11.3 |
| Terminal-Bench v2.1 | 终端 / 命令行工作 | 63.7 | 72.2 | +8.5 |
要害在于泛化的跨度:训练任务全是「实现被删掉的功能」这一种形态,但收益覆盖了 issue 修复、从零建程序、语言翻译、终端操作四类完全不同的软件工作。ProgramBench 的 4.5 → 21.5 尤其显眼——不过也要注意,基线只有 4.5 分,接近地板,这种低基线上的绝对增益天然比高基线上的好看(对比 SWE-bench Pro 从 50.3 起步只涨 4.1)。
内部验证集 CodeMidas Val(200 个与训练集不相交的任务,每任务 3 次尝试)上,pass rate 从 35.0% 升到 44.7%,从第 40 步起稳定高出初始策略 8–10 个百分点;同时平均轨迹总长度上升,说明模型学会了更充分地用掉给它的交互预算,而不是早早收手。
06消融:规模重要,但质量更重要
四组设置,训练配置完全相同:高质量池的 1k / 3k / 5k(即全量 5,545),外加一个「vanilla 8k」——约 8,000 个在过滤前采样的任务,每个同样有陈述、环境和验证器,但没有做环境清理、没有执行一致性检查、没有任何一道 post-rollout 过滤。
| 训练任务池 | SWE-bench Pro | DeepSWE | CodeMidas Val |
|---|---|---|---|
| 高质量 1k | 52.86 | 17.57 | 41.30 |
| 高质量 3k | 54.02 | 19.05 | 43.22 |
| 高质量 5k(全量 5,545) | 54.40 | 21.70 | 44.73 |
| Vanilla 8k(未过滤) | 53.81 | 17.11 | 40.24 |
| 5k 相对 8k | +0.59 | +4.59 | +4.49 |
两个结论:
- 规模有效:1k → 3k → 5k 在三个评测上单调上升,DeepSWE 从 17.57 到 19.05 到 21.70。学习曲线上,全量池从第 40 步起在每一个评测 checkpoint 上领先,优势持续到第 70 步(44.73)。
- 质量压过规模:高质量 3k 在三个评测上全面超过 vanilla 8k,用不到一半的任务量。未过滤的 8k 甚至比高质量 1k 还差(DeepSWE 17.11 vs 17.57,Val 40.24 vs 41.30)——也就是说脏环境带来的负收益能把 8 倍的数据量吃干净。
vanilla 8k 是一次性关掉了五样东西(环境清理、执行一致性、泄漏过滤、解答审计、rollout 结果过滤)。所以它只能证明「这五样加起来有用」,无法说明哪一样是关键。从工程角度这是最想知道的问题:如果只做最便宜的六容器一致性检查能拿回多少?泄漏过滤这种要跑对抗 agent 的昂贵步骤,边际收益值不值?论文没有回答。
07行为分析:agent 到底学会了什么
论文没有止步于分数,而是去量化 RL 过程中轨迹行为的变化,定义了三个指标(附录 B):
- 代码库探索:第一次编辑代码之前,去重后的 read/search 请求数。相同文件+行范围的读、相同查询+范围+选项的搜索只算一次;通过专用工具和 shell 命令发出的等价请求算重复。
- 代码起草:对每个 Write/Edit 载荷,按 4 字符步长采样 16 字符的去重片段,统计有多少能在该次写入之前的 reasoning 里找到。命中数 / 采样总数 = drafting ratio,衡量「写之前有没有先想」。
- 自我验证:最后一次代码编辑之后执行的去重验证命令数,包括项目测试命令、内联检查、临时测试程序和本地运行。
| 行为 | 度量 | 训练早期 | 训练后期 | 变化 |
|---|---|---|---|---|
| 代码库探索 | 首次编辑前 read/search 次数 | 27.2 | 40.1 | +12.9 |
| 代码起草 | drafting ratio | 0.358 | 0.629 | +0.271 |
| 自我验证 | 编辑后去重命令数 | 2.03 | 2.53 | +0.50 |
模型学到的是一套「先看够、再想清、写完验」的工作方式:动手前的探索量涨了近 50%,写出来的代码有 63% 的片段能在之前的推理里找到(早期只有 36%),验证手段也更多样。
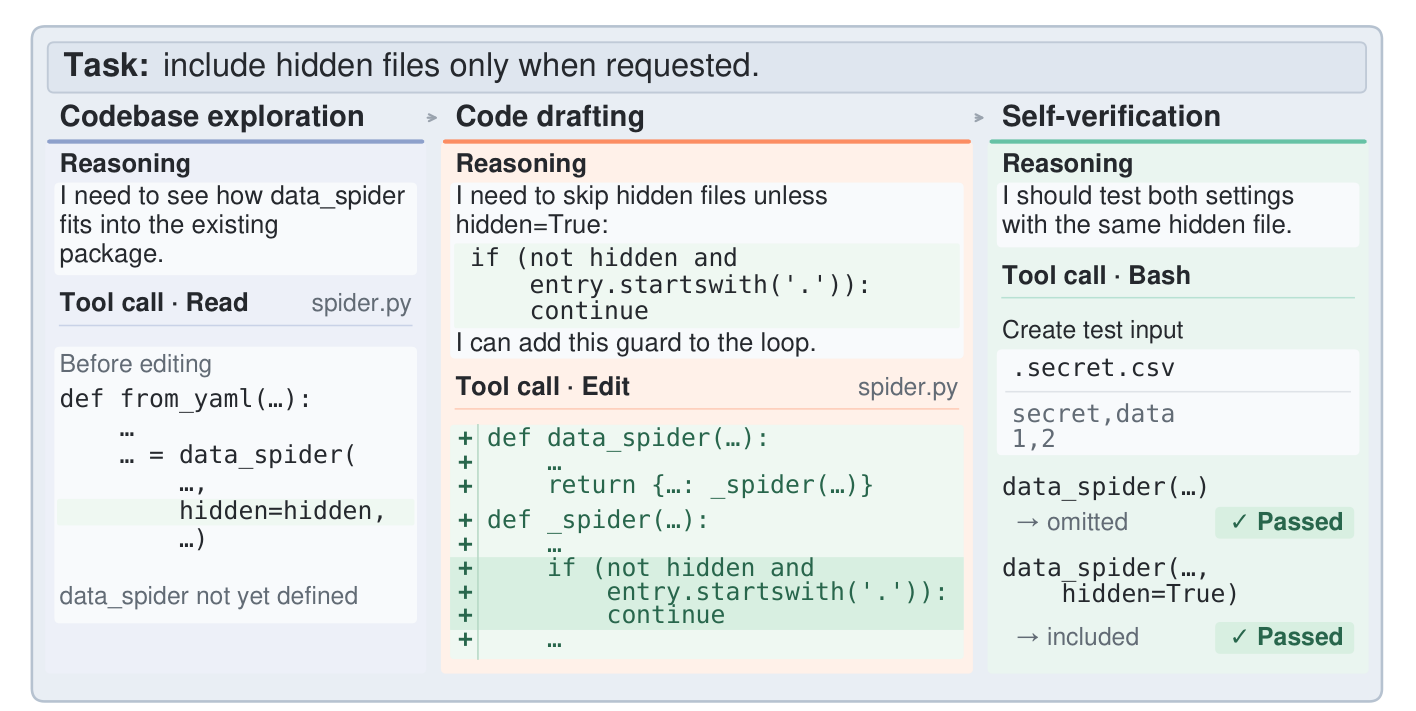
data_spider 怎么嵌进现有包,再在 reasoning 里起草隐藏文件过滤逻辑并通过 Edit 落地,最后自己造一个 .secret.csv 把 hidden 两种取值都测一遍。哪个行为真的和成功相关?
在 CodeMidas Val 上控制同一任务、同一 checkpoint 比较:有 agent 自己写并执行检查的 rollout,平均 pass rate 高 4.2 个百分点(95% CI:1.8–6.6)。而按 checkpoint 中位数切分的探索量差异只有 +0.7 pp(CI −1.9 到 3.7)、起草比例 +1.95 pp(CI −0.04 到 3.96)——两个置信区间都跨 0。
换句话说:探索得多、想得细,在训练中确实一起涨了,但单看它们并不能预测这一条 rollout 会不会成功;自己写测试能。这对奖励设计有直接启发——如果想加行为塑形,self-verification 是目前唯一有证据支持的抓手。
行为变化会迁移到外部任务
| 评测 | 探索 (read/search) | 起草 (ratio) | 自我验证 (命令数) | 交互长度 (assistant 轮) |
|---|---|---|---|---|
| SWE-bench Pro | 23.1 → 35.5 | 0.304 → 0.653 | 0.80 → 0.96 | 37.3 → 50.1 |
| ProgramBench | 55.7 → 83.6 | 0.106 → 0.361 | 0.93 → 0.99 | 155.1 → 122.8 |
| Terminal-Bench v2.1 | 11.9 → 16.8 | N/A | 2.01 → 2.61 | 59.2 → 69.5 |
原文表 3,取各 benchmark 最早三个与最后三个观测 checkpoint 的均值。
探索在三个 benchmark 上一致上升,这是泛化的行为层面证据,比单纯的分数更有说服力。最有意思的是 ProgramBench 那一行:探索涨了 50%,总交互轮数反而从 155 降到 123。在从零构建程序的场景下,前期把代码库/需求看透,换来的是后期少走弯路——「探索更多 = 更慢」的直觉在这里不成立。而 issue 修复(SWE-bench Pro 37.3 → 50.1)和终端任务(59.2 → 69.5)则是轮数增加,说明交互预算该怎么花是任务类型相关的,模型学到的不是无脑拉长。
08局限与我的几点存疑
- 参考解的正确性被默认为真。整条流水线的期望值来自执行原始代码。如果原实现本身有 bug 或有平台相关的怪行为,这个行为会被固化成测试期望,agent 必须复现这个 bug 才能拿奖励。论文没有讨论这个风险,也没有任何机制去检测它。
- 只在一个初始策略上验证。全部实验都是 MiMo-V2.5 + GRPO。数据集对其他基座、其他 RL 算法的效果未知;尤其是初始策略在 CodeMidas Val 上就有 35% pass rate,说明任务难度是围绕这个模型的能力带来校准的(rollout 结果过滤那一步用的是「frontier model」的全对/全错)——过滤步骤本身就带有模型依赖性,换个能力差很多的模型来训,任务分布可能整体偏难。
- 构造成本完全没有披露。「每个阶段都分配 agentic compute」意味着:探索代码库的 agent、写测试的 agent、审查断言的 agent、装环境的 agent、对抗泄漏的 agent、审计解答的 reviewing agent、外加 frontier model 的多次尝试……22,575 个候选走完全程才留下 5,545 个。平均每个可用任务烧了多少 token / 多少容器小时,论文一个数字都没给。这是复现这条 pipeline 最需要知道的信息。
- 过滤步骤无法单独归因(见 §06)。
- drafting ratio 的定义偏脆。「16 字符片段在之前 reasoning 里出现过」会把变量名、常见语法结构、以及从文件里读来又原样贴回去的代码都算成「起草过」。0.358 → 0.629 的变化方向可信,但绝对值不宜过度解读。
- 数据与代码的开放性未提及。论文正文没有给出数据集或流水线的发布计划。
- 「删实现」这种任务形态有其偏置。所有任务都是「把一个洞填上」,且 public 接口是给定的。真实开发中大量工作是接口设计本身、是跨模块重构、是在没有明确边界的情况下判断该改哪里——这些形态不在覆盖范围内。ProgramBench 上的迁移效果说明泛化确实存在,但形态偏置是结构性的。
09值得带走的三点
- 「代码即环境」把供给瓶颈换了个位置。以前任务量受限于 issue/测试/文档的覆盖率,现在受限于你愿意投多少 agentic compute。前者是硬天花板,后者只是钱的问题——而且它顺带解锁了 23 种语言,这是依赖语言特化工具链的方法拿不到的。
- 验证器的质量不是「锦上添花」,是决定性的。高质量 3k 打赢未过滤 8k,未过滤 8k 甚至打不过高质量 1k。如果只能抄一件事回去,我会抄六容器执行一致性检查(2 次空跑必失败 + 4 次参考解必通过)和全对/全错任务直接丢弃——这两条几乎零智力成本,却能同时挡住 flaky、挡住已解决任务、挡住零梯度样本。其次是断言复审:让一个独立 agent 把「精确文案 / 偶然顺序 / 内部结构」这类陈述不支持的断言改成行为检查,直接对应 RL 里的假阴性噪声。
- 自我验证是唯一被证据支持的行为抓手。探索和起草在训练中都涨了,但只有「agent 自己写并跑检查」与更高 pass rate 有显著关联(+4.2 pp,CI 1.8–6.6)。这条对任何做 coding agent 的人都直接可用——无论是加进 system prompt、作为奖励塑形项、还是作为轨迹筛选信号。