GAGAR:分组评分与优势再分配
通过测试之后,怎样让更好的实现得到更多训练信号?从评分证据、权重公式到训练稳定性,拆解一套代码 Agent 的质量反馈机制。
GAGAR 的核心,是把同一道题上“都通过测试”的实现继续分出质量高低,再在这些成功轨迹之间重新分配 advantage。测试提供成败信号,评分 Agent 提供组内质量偏好;两种信号通过一套明确的权重规则结合。
- 比较对象是同题的多条完整轨迹。评分器能读仓库、补丁和日志,也能执行检查;失败轨迹提供上下文,但质量排序只针对有效的成功解。
- 理想形式保留成功轨迹的 advantage 总量。先按质量打折,再统一放大,将被扣掉的份额按比例重新分配。
- 训练实现有额外保护。Flash 把放大系数上限设为 1.5,再做组内重中心化。上限生效时,理想公式的严格守恒性质需要重新审视。
01二元奖励遗漏了什么
代码 Agent 的一次 rollout,通常包含读文件、定位问题、修改实现、运行测试等多轮交互。最终测试通过记作 1,失败记作 0。这个信号便于自动化,也直接对应“有没有完成任务”,但它无法充分表达补丁的可维护性和任务边界。
设想两条轨迹都修复了某个输入解析问题:一条定位到公共解析函数,补上恰当的边界处理;另一条在多个调用点分别增加特判,还顺手改了无关接口。现有测试可能都通过,但后者带来更多审查负担,也更容易在未覆盖的场景出问题。这是帮助理解的情境示例,不是论文给出的具体案例。
本文使用均值中心化的 outcome advantage。设一组有 n 条有效轨迹,其中 m 条通过,组通过率 p = m/n:
所有成功轨迹得到相同的正 advantage。这里的 advantage 可以理解为策略更新中的有符号权重:正值倾向于强化采样到的行为,负值倾向于抑制它;它并不是独立的代码质量分数。只看二元奖励时,模型没有额外信号区分“干净地完成任务”和“勉强通过测试”。
GAGAR 保留测试这个基础判据,再引入同题比较。为什么强调同题?因为需求、初始仓库和执行条件一致,更容易判断哪些修改必要、哪些复杂性可以避免;不同任务之间直接比较代码质量,会混入任务难度和实现规模的差异。
论文通过 dynamic sampling 保留既有成功、又有失败的组,即 0 < p < 1。全成功或全失败时,本文的原始二元 advantage 全为零,不进入这里讨论的训练组。因此,本方法没有直接解决“全成功组如何继续学习质量偏好”的问题。
02一组样本如何进入训练
这套方法最适合沿着一组样本的生命周期理解。它在原有 rollout、测试验证和策略更新之间,插入了“质量评分 → 优势调整”两个环节。
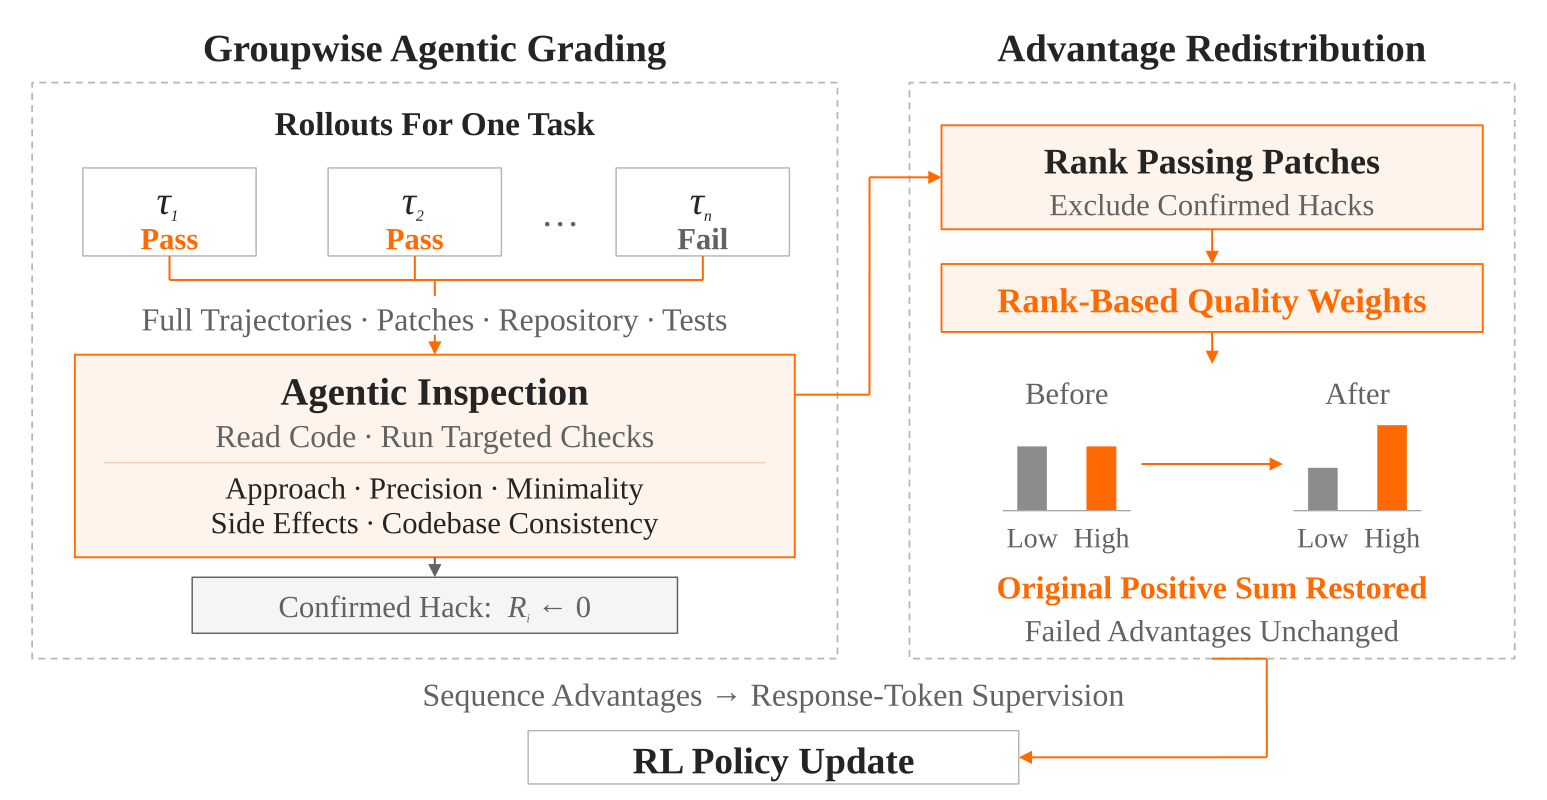
这里有两个容易混淆的动作。发现已确认的答案泄漏或外部答案依赖,会把奖励改成 0;发现实现不够精确或改动过多,则影响成功解的质量因子。前者改变样本的成败身份和组通过率,后者在既定成功集合内调整学习权重,不能合并成一种“扣分”。
03评分器怎样判断质量
先定位证据,再下结论
评分器使用一个共享工作空间,能够访问同题的需求、仓库、完整轨迹、补丁和测试结果。它先读逐轮摘要,找到需要核查的位置,再按需深入具体轨迹,并与仓库实现和测试日志交叉验证。静态阅读无法解决的问题,可以通过针对性执行检查补充证据。
失败轨迹也有用:它们揭示哪些路径走不通、哪些要求容易漏掉,为成功解的比较提供参照。但失败轨迹不参与成功解的质量因子分配。评分器的负面判断需要指出相应的补丁位置、轨迹事件或执行结果;证据不足以区分两个候选时,允许并列。
五个维度分别看什么
| 维度 / 权重 | 重点关注 | 较差实现的信号 |
|---|---|---|
| 方案适合度 · 30% | 策略是否解决根因,是否适合任务 | 只绕过症状,采用根本不合适的方案 |
| 实现精确性 · 25% | 修改位置是否准确,行为是否完整覆盖 | 分散特判,冗余的 fallback 逻辑 |
| 改动最小性 · 20% | 是否限于实现需求所必需的修改 | 无关重构、多余辅助函数或分支 |
| 副作用控制 · 15% | 是否保留周边行为和公共接口 | 改变无关行为,在核心路径引入风险 |
| 代码库一致性 · 10% | 是否复用现有抽象、遵循已有约定 | 另造临时机制,风格或注释不一致 |
每一项给 1–5 的整数分,先计算加权分 W。这个分数用于初始排序,随后还要考虑质量层级以及有证据支持的比较修正。
“改动最小”不能机械地解释为 diff 越短越好。这里评估的是修改是否必要、是否限定于任务范围。一个较长但覆盖完整的根因修复,可能优于几行隐藏症状的特判。这是对评价维度的理解,不能据此推断评分器已经完全消除了短补丁偏好。
评分器本身也有工程成本
Flash 和 Pro 的在线评分均使用同一个 MiMo-V2.6-Pro 的 pre-RL SFT checkpoint。论文报告,初始使用 Claude Opus 5 时,每组端到端评分平均约 2,000 秒;换用其 SFT 评分器后约为 600 秒。由于评分要等一组 rollout 完成后才能开始,作者把已完成组的评分与其他任务的 rollout 重叠执行。
这解释了为什么它需要调度系统支持:一次质量比较本身也可能是较长的 Agent 任务。600 秒是评分延迟指标,不能直接换算成固定比例的训练算力开销,也不能据此认为在线训练完全没有等待。
依据:原文 §3.2、附录 A.1 / 表 2。
04从质量分层到折扣因子
质量分 W 并不直接乘到 advantage 上。实际步骤是先分层,再在层内排序,最后把名次映射成 fᵢ ∈ (0, 1]。分层规则按固定顺序应用:
- 先判 T₃:明显质量缺陷。包括已确认的非需求重写或针对测试的权宜实现、方案适合度最低分,或者改动最小性与副作用控制两项都不高于 2。
- 再判 T₁:高质量实现。在未进入 T₃ 的候选中,五项均至少为 4,且没有严重过程问题或未解决的回归。
- 其余进入 T₂。层内参考 W 排序,评分器可以根据具体证据修正顺序,也允许并列,但排序必须遵守层级。
令 k 为该候选所在“并列组”在本层中的序号,从 0 开始;K₂ 是 T₂ 层的并列组数量。Flash 的映射参数如下:
| 候选位置 | 质量因子 f | 含义 |
|---|---|---|
| T₁ 第一并列组 | 1.0 | 保留完整的折扣前权重 |
| T₁ 其余并列组 | 0.9 | 轻微折扣 |
| T₂,K₂ > 1 | 0.85 − 0.45 × k/(K₂ − 1) | 从 0.85 线性下降到 0.4 |
| T₂,K₂ = 1 | 0.85 | 整个层只有一个并列组 |
| T₃ | 0.2 | 使用固定的最大折扣 |
例如 T₂ 内排序为 A = B > C > D,则有三个并列组,A、B 都是 0.85,C 是 0.625,D 是 0.4。这里数的是不同的并列组,不能因为 A、B 占了两个候选位置,就把 C 当成 k = 2。
f = 0.2 表示折扣阶段保留 20%,不表示最终训练权重必然只有原来的 20%。后面还要统一放大,实际相对原始 advantage 的倍数是 λf;在理想公式下,它也等于 f 除以成功集合的平均 f。
依据:原文附录 A.1,式 (5)–(6)。上述参数对应 Flash 配置,不据此假定所有训练设置都使用相同参数。
05优势再分配的推导
只打折,会改变正负信号的总量关系
用 P 表示成功集合,F 表示失败集合。原始均值中心化优势的组内和为零。若只将成功解乘以 fᵢ,而失败解不变,被移除的正 advantage 为:
这一步既表达了质量偏好,也削弱了成功样本整体的强化信号。GAGAR 希望保留前者,同时把扣掉的正 advantage 重新分配回成功集合。
一个公共系数恢复总量
因为保留组至少有一个成功解,且 fᵢ > 0、成功 Aᵢ > 0,分母严格为正。对成功集合求和,分母会被约掉,因此 Σ Aᵢ* = S₊;失败集合原样保留,所以全组 advantage 的和仍然为零。
在二元奖励下,所有成功解的原始 advantage 都是 1 − p,于是还可以化简成更直观的形式:
因此,f 高于组内成功解平均值的候选得到额外份额,低于平均值的候选让出份额。公共放大保留了质量因子的比例关系,整个变化是在成功集合内部完成的。
几个直接推论
- 只有一个成功解时,不发生再分配。它的折扣会被 λ 恰好抵消。
- 所有成功解 f 相同时,也不发生再分配。哪怕它们的 f 都是 0.2,理想公式最终仍回到原始优势。
- 同组所有 f 同乘一个正数,理想结果不变。影响分配的是相对比例,而非共同的绝对尺度。
- 较差的有效成功解仍有正 advantage。理想形式降低其强化程度,不会因为排序靠后就把它变成负样本。
这些性质属于未截断的二元奖励公式。后文的放大上限、重中心化和非二元奖励后处理,会改变其中一些结论的适用条件。
一次策略更新还包含 token 数量、损失聚合、重要性比率、裁剪、响应 mask,以及每个 token 自身不同的梯度方向。Σ Aᵢ 不变,只约束序列级权重的代数和,不能推出梯度向量、梯度范数或有效更新幅度相同。本文训练实现使用 token-mean,这一点尤其需要区分。
公式与退化情形:原文 §3.3,式 (1)–(4)。共同缩放不变性及梯度解释为本笔记据公式给出的补充分析。
06四条轨迹的完整算例
本节数值是解读者构造的教学示例,不是论文实验,也不代表 Flash 的实际档位。设四条轨迹的结果为 [1, 1, 0, 0],成功解 A、B 的质量因子分别为 1 和 0.5。p = 0.5,成功优势总量 S₊ = 1。
| 处理阶段 | 成功 A | 成功 B | 失败 C | 失败 D | 组内和 |
|---|---|---|---|---|---|
| 原始 advantage | 0.5 | 0.5 | −0.5 | −0.5 | 0 |
| 只乘质量因子 | 0.5 | 0.25 | −0.5 | −0.5 | −0.25 |
| 再乘 λ = 4/3 | 2/3 | 1/3 | −0.5 | −0.5 | 0 |
原来的成功权重比是 1:1,调整后是 2:1;成功总量恢复到 1。注意,并不是把扣掉的 0.25 全部送给 A:它按折扣后的 2:1 比例分回 A、B,两者分别收回 1/6、1/12。
为什么“扣奖励再减均值”不是同一回事
如果把成功奖励直接从 [1, 1] 改成 [1, 0.5],完整奖励变成 [1, 0.5, 0, 0],新均值为 0.375。得到的 advantage 是:
两者组内和都为零,但直接折扣奖励改变了失败样本的权重,也把成功样本的比例改成了 5:1。可见,“保持零均值”比“保留成功总量、失败权重和质量比例”更弱。
另一种做法是先对 advantage 打折,再直接减去其均值。本例会得到 [0.5625, 0.3125, −0.4375, −0.4375],同样满足零均值,也同样不等于 GAGAR 的目标分配。
可以在 reward 空间实现,但要构造正确的变换
附录 A.3 给出了等价奖励 R′ᵢ = Aᵢ* + p。本例为 [7/6, 5/6, 0, 0],均值仍是 0.5,减去均值后正好得到目标优势。这些值只是优化信号,允许超过 1,不能当成新的测试通过标签。
等价性依赖于这里的均值中心化估计以及相同的其他更新设置。如果随后把奖励裁剪回 [0, 1],或额外按奖励标准差归一化,一般就破坏了等价性。
对照思路和等价变换:原文附录 A.3,式 (9)–(11);本节各数组由本笔记计算。
07实际实现:上限与重中心化
理想公式里,λ = 1/f̄P。如果所有成功候选都被严重打折,恢复全部正 advantage 需要较大的 λ。训练实现为公共放大系数设置上限,然后再次减去整个有效组的均值。
上限未触发时,mean(B) = 0,这与理想公式完全一致。上限触发时,恢复的正份额不足,mean(B) 为负;重中心化给每条轨迹加上同一个正偏移量,使组内和重新回到零。这时失败样本也会变化,成功解之间原先的权重比也一般不再保留。二元情形下,成功解的排序仍然保留,因为共同平移不会改变大小关系。
一个触发上限的例子
仍然使用 [1, 1, 0, 0],这次两个成功候选的 f 都为 0.2。以下也是教学算例:
最终的成功优势总量为 0.65,而原来是 1;失败优势的总绝对值也缩小到 0.65。这个例子说明:理想版本对统一折扣完全不敏感,实际版本在上限触发时却会改变整组信号强度。因此,讨论实验中的“守恒”时不能略过这一保护分支。
叠加长度等 reward 后处理时
如果训练系统已经将奖励处理为非二元标量 rᵢ,先计算 aᵢ = rᵢ − mean(r)。成功身份仍由验证结果决定,但成功轨迹的 aᵢ 此时不一定相等,甚至可能不是正数。附录采用成功优势的正部 aᵢ⁺ = max(aᵢ, 0) 参与加权:
分母为零时跳过再缩放,最终仍按附录要求做有效组中心化。非二元情形下,最终权重同时取决于原始 aᵢ 和质量因子 fᵢ,不能再用“f 的顺序就是最终优势的顺序”概括。工程复现还需要明确分母为零时中间量的回退约定,避免除零或未初始化值。
依据:原文附录 A.2,式 (7)–(8)。上限算例及统一折扣的比较为解读者推导。
08在线接入与异常处理
公式以外,数据身份、评分有效性和执行时序同样重要。论文给出了以下规则:
- 基础设施失败先 mask。不能评估的轨迹不参与有效组均值;确认任务评测本身损坏时,整组退出训练。环境坏了和模型做错了必须区别处理。
- 确认作弊后重算统计。相关奖励归零,更新成功/失败集合与组均值,然后再判断该组是否满足使用条件。
- 评分结果要验证完整性。例如成功轨迹不能在排名中缺失;评分无效或不可用时,回退到原来的 outcome 学习信号。
- 参考补丁不是质量模板。可用它辅助理解任务,但与参考补丁的相似度不是评分标准;参考补丁也不属于采样轨迹,不分配训练优势。
- 序列 advantage 作用于模型响应 token。论文没有在组内对齐每一个中间状态,也没有给每次工具调用单独分配局部质量奖励。
便于对照实现的伪代码
下面仅展示二元奖励主路径和有上限的更新顺序,是阅读辅助,不是作者发布的实现;非二元后处理应另按上一节处理。
group = remove_infrastructure_invalid(rollouts)
if task_evaluation_is_broken(group):
    skip_group()

R = verified_outcomes(group)
R = apply_confirmed_integrity_corrections(R)
if not (0 < mean(R) < 1):
    skip_group()

A = R - mean(R)
P = (R == 1)
f = validated_grading_factors_for_passes(group)
if f is unavailable:
    return A

lambda_exact = sum(A[P]) / sum(f * A[P])
B = copy(A)
B[P] = min(lambda_exact, 1.5) * f * A[P]
return B - mean(B)
实现时需要让轨迹 ID、仓库状态、评分证据与当前有效样本一一对应。评分异步返回后,若错误地按列表位置对齐另一个组,公式即使正确也会把偏好加到错误样本上。这是本笔记补充的工程检查重点。
09主实验与效率变化
先看能用于归因的受控实验
主实验从 MiMo-V2.6-Flash 的 pre-RL SFT checkpoint 开始,模型为 310B 总参数、15B 激活参数。训练只包含代码任务,每批 128 个 prompt,每题 16 条 rollout,采用 token-mean 损失聚合。对照是没有在线质量评分的二元 outcome 基线。
评测使用 DeepSWE v1.1 和 SWE-bench Pro,每题采样三次并报告平均通过率 avg@3。这里不能把 avg@3 读成“尝试三次至少成功一次”的 pass@3:前者对采样结果取平均,后者关注至少一次成功。
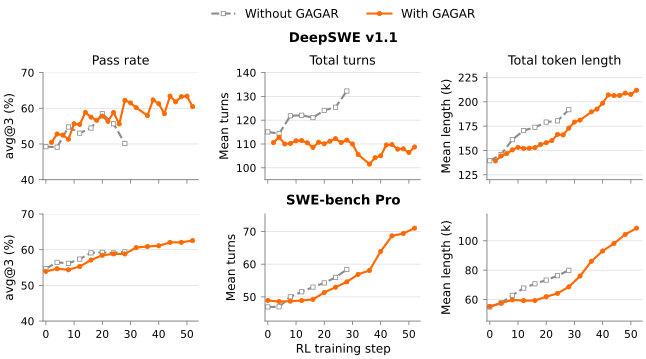
第 28 步是二元基线停止前的共同检查点,论文正文报告:
| 指标 · 第 28 步 | 二元基线 | GAGAR | 变化 |
|---|---|---|---|
| DeepSWE avg@3 | 50.2% | 62.2% | +12.0 百分点* |
| DeepSWE 平均轮数 | 132.3 | 111.6 | −15.6% |
| DeepSWE 平均 token | 191.9k | 172.9k | −9.9% |
| SWE-bench Pro 平均轮数 | 58.4 | 54.6 | −6.5% |
| SWE-bench Pro 平均 token | 79.9k | 68.6k | −14.1% |
* 原文正文写“提升 12.1 个百分点”,但其展示的 62.2 − 50.2 = 12.0。本表按展示值计算;差异可能涉及未展示精度,也可能是文本误差,原文未解释。
二元基线的 DeepSWE 通过率从第 20 步的 58.5% 降至第 28 步的 50.2%,作者因性能快速恶化而停止该训练。与此同时,其轨迹增长,更容易被长度上限截断。GAGAR 在共同检查点使用更少的轮数和 token,并能继续训练:DeepSWE 在第 44 步达到峰值 63.4%,SWE-bench Pro 在第 52 步达到 62.5%。
这里有两个不同结论:同一步数的差异支持质量反馈的实际收益;更晚的峰值说明该训练配置能持续更久,但多训练的部分也消耗额外预算,不能当作等训练成本的提升。
大规模混合任务训练说明适用性
作者还把方法接入 Flash 和 Pro 的混合任务 RL:每次更新 1,568 个 prompt,每题 16 条 rollout,名义上共 25,088 条;评分与再分配作用于其中符合条件的代码任务组。Pro 为 1.02T 总参数、42B 激活参数。
| 混合 RL 后的模型 | DeepSWE | SWE-bench Pro |
|---|---|---|
| MiMo-V2.6-Flash | 67.9% | 60.9% |
| MiMo-V2.6-Pro | 71.9% | 62.7% |
这些是完整混合训练系统的最终结果,说明方法可以融入较大规模训练;它们没有单独隔离 GAGAR 的贡献。不能把 Flash 的 67.9% 或 Pro 的 71.9% 全部解释为“优势再分配带来的效果”。
10消融与代码质量审计
消融:只打折,还是打折后再分配
这组消融固定质量评分的思路,比较完整方法与 downweighting-only。后者只削减成功轨迹的 advantage,不恢复被移除的正份额,也不做随后的组内重中心化。它和前面“直接改 reward 再减均值”的方法不是同一个对照。
| 训练或评测指标 | 仅打折 | 完整方法 |
|---|---|---|
| 策略熵 · 第 1 → 30 步 | 0.359 → 0.905 | 0.358 → 0.513 |
| 训练 rollout token · 第 1 → 30 步 | 47.1k → 114.1k | 46.5k → 69.9k |
| 平均策略梯度损失 · 第 1–30 步 | 0.0304 | 0.0021 |
| DeepSWE avg@3 · 第 28 步 | 56.2% | 62.2% |
| DeepSWE 平均轮数 · 第 28 步 | 143.5 | 111.6 |
| DeepSWE 平均 token · 第 28 步 | 236.0k | 172.9k |
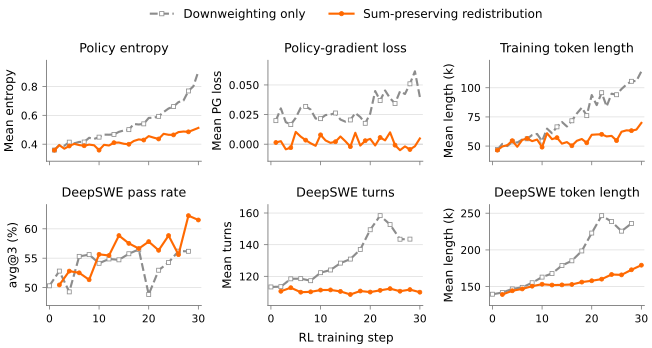
仅打折的训练出现更快的熵和长度增长,评测也更不稳定。这支持了作者在当前配置下恢复正向学习信号的设计,但并不构成“任意非零均值优势都会导致发散”的定理,也不能推出所有 reward shaping 都不稳定。
策略梯度损失的数值还要单独解释:当重要性比率接近 1 时,目标中的损失近似与加权平均 advantage 的负值相关。正 advantage 被移除后,损失可能因为符号和基线变化而升高;因此,0.0304 与 0.0021 不能像分类损失一样,直接解读为后者拟合得好十几倍。
审计:通过率之外,补丁质量是否改善
作者固定随机抽取 30 个 DeepSWE 任务,在共同评测检查点做盲评。每个任务汇集两种方法各最多三条轨迹,包括失败样本;候选 ID 匿名化,顺序随机化。审阅模型为 Claude Opus 5,与在线评分的 MiMo-V2.6-Pro 不同,但使用同一套五维质量标准。
GAGAR / 二元基线
来自组内联合排序
跨方法并列时平分
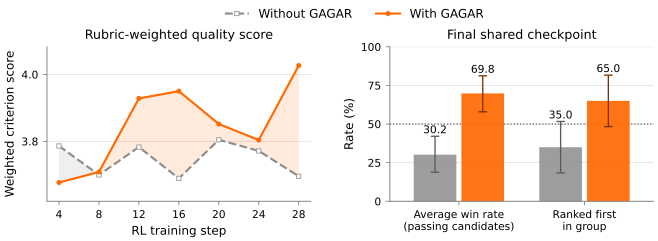
作者报告改进较明显的维度是实现精确性、改动最小性和副作用控制;最高质量层 T₁ 的候选占比由 25.4% 增至 34.3%。这些结果与设计目标一致,但 30 个任务的审计覆盖有限,且评审仍由模型完成。它补充了通过率指标,没有替代人工代码审查。
11结论边界与待验证问题
以下是解读者的分析与建议,并非论文已经验证的结论。
评分偏好最终决定训练往哪里走
测试把基本成败固定下来,但“更好的实现”仍由评分器及其 rubric 定义。即使要求附证据,也可能系统性偏好熟悉的代码模式,误判必要重构,或忽略隐蔽回归。换一个审计模型有助于减少直接的同模型自评,却不能自动消除共同偏差。更有说服力的补充应包含与维护者判断的一致性,以及评分器反复评同一组时的稳定性。
严格守恒与实际训练之间,还差一个触发率
附录公开了 λmax = 1.5,但没有在本文中给出各训练阶段上限触发的比例。这个比例很重要:很少触发时,理想再分配是较好的近似;频繁触发时,实际方法更像“有界质量重权重 + 全组中心化”。记录 λ 分布、触发率和失败 advantage 的变化,才能判断训练主要运行在哪个分支。
损失聚合方式可能影响长度现象
主对照采用 token-mean。更长的轨迹贡献更多 token 项,序列级权重与长度之间可能形成反馈。论文的实验支持当前配置下的稳定性改善,但不足以单独回答:换成按序列或 prompt 平均后收益还剩多少?在聚合方式和长度惩罚固定的条件下做交叉消融,会更容易区分各因素的作用。
还不能拆出每个评分组件的独立贡献
二元基线与完整 GAGAR 的比较,同时引入了组内审阅、可执行检查、质量标准和再分配。现有“仅打折”消融主要检验权重分配方式;它没有分别回答组内评分优于逐条评分多少、执行检查优于纯文本审查多少,以及五个质量维度是否都必要。
质量收益与总体成本需要一起看
更少的推理轮数和 token 有实际价值,但训练增加了评分成本。等步数比较、等采样 token 比较和等总计算预算比较,回答的是不同问题。若要判断部署到自己的训练系统是否划算,需要把评分算力、排队延迟、失败回退比例,以及推理侧节省的开销一起计入。
轨迹级比较没有解决细粒度归因
一个最终补丁很好,不代表此前每次工具调用都有效。把同一个 advantage 广播到全部模型响应 token,会共同强化这条轨迹里的有效步骤和冗余步骤。本文通过整体质量偏好间接改善行为,但没有直接判定“哪一步值得奖励”。这也是它与逐步过程奖励、状态级或 token 级 credit assignment 的区别。
12复现重点与相关阅读
如果要把这套方法接入现有代码 Agent RL,最先对齐的是四件事:有效组的定义、成功候选的评分覆盖、从层级到 f 的映射,以及放大上限后的重中心化。只实现 A ← fA,会变成论文明确单独比较的“仅打折”变体。
- 有效组成功数、被排除轨迹数、作弊纠正前后的组通过率。
- T₁/T₂/T₃ 分布、并列比例、f 的均值与分布、评分回退率。
- λ 的分布、上限触发率、调整前后成功/失败优势总量。
- 训练与评测各自的长度、截断率、通过率,以及评分延迟和总成本。
这些是本笔记的实施建议,目的是判断“质量偏好是否可靠”和“优势调整是否按预期工作”,不代表论文已经公开了全部相应日志。
读完应能区分三个层次:评分层负责提出有证据的相对质量偏好;理想分配层保持成功总量和失败权重;训练实现层加入上限、中心化与已有 reward 后处理。论文的实验评估最终训练系统,公式的严格性质则必须按各自前提理解。