TerminalHorizon:
让环境留下真正需要做的工作
长轨迹的价值,是后面的判断确实用上了前面的证据。先理解任务怎么造,再读懂约 3K 条 SFT 轨迹带来的收益,以及这些实验还回答不了什么。
如果造题时已经把分析结果、关键实现和正确方案塞进环境,学生看见的“复杂任务”就可能只剩改一个常量。TerminalHorizon 的核心,是通过独立试做找出这些被提前完成的工作,再重建环境,让探索、诊断、实现和验证真正发生在求解过程中。
来源:论文 §3、表 2 与项目页。轨迹轮数不是 token 数;数据规模不是训练成本。TB 2.1:Qwen3.5-27B 46.82 → TerminalHorizon-27B 60.67。
01论文到底改变了什么
这是一项环境与训练数据构造工作。最终模型通过监督微调(SFT)学习教师在终端里的多轮行为;主要实验没有引入新的策略优化目标,也没有在这批任务上报告 RL 训练收益。它对 Agentic RL 的意义首先在任务、轨迹与验证器这一侧。
作者用 27 类行为描述长程工作,并归成五组:信息探索与判断、诊断与纠错、构建与推进、验证与确认、策略与执行协调。关注点在它们如何连接:日志改变假设,假设决定下一次实验,实验结果决定保留哪次修改,最后再核对交付物。
“连续调用了 50 次工具”只能说明交互多。“第 30 次观察推翻了第 10 次的判断,促成新实现,并在最终回归中被验证”才展示了跨阶段的问题求解。后一句是本站的教学表述,概括论文的设计目标,并非作者使用的自动评分公式。
依据:论文 §1、§2.1、§3;27 类模式的定义见附录 E。
02先让独立求解者暴露造题问题
任务包可以写成 T = (I, E, S, V, M):公开指令、可执行环境、参考解、私有验证器和执行配置。学生求解时只能看到公开指令与环境;参考解和私有测试留在构造与评估侧。私有测试可以保密,但被要求完成什么,必须能从公开需求和可发现的环境证据中得知。
结合已有任务和反馈选择覆盖不足的方向,调查文档、代码与实际问题,形成任务种子和判断完成情况的依据。
同时建立初始状态、公开要求、参考实现、验证器与配置,避免题目和评分各说各话。
只给公开信息,检查它实际做了什么,哪些分析、实现或验证被初始环境提前完成。
修改初始材料、对象关系、接口反馈和待实现部分,并同步更新需求与评分;有效经验也反馈给下一批规划。
例如,一个任务要求实现核心算法,但环境中已有完整实现,求解者只切换一个参数就能通过。作者要恢复的是缺失的实现和调试工作。高效地完成真实要求仍然是有效解法;重建不应惩罚一个更聪明的短解。
依据:论文 §2.1–2.2。上例沿用论文对“核心功能已被环境提供”的解释,以中文重新表述。
03渐进扩展:让下一阶段依赖前一阶段
一个能运行、能评分的任务,是扩展的起点。作者围绕同一个目标增加职责、补足更深的机制、加入更丰富的证据,或要求升级方法。扩展还要检查:原来的解法是否已经能直接满足新要求;如果能,就未必增加了新的实质工作。
关键是把新要求落在交互依赖上:后续决定需要之前查到的证据;工具动作造成可观察的后果,要求后续诊断与纠正;实例状态变化后,模型需要重新检查、适配并验证。扩展后的环境、公开指令、参考解与评分条件一起更新。
第一版只把源照片导入目标库。第二版允许两端分别修改评分,就需要比较“上次同步状态、源端新值、目标端新值”。再加入删除与恢复,就需要判断删除是否会覆盖目标端之后的新编辑。新增工作来自状态之间的关系与冲突,而不是单纯把照片数量扩大十倍。
方法依据:论文 §2.3。照片同步例子依据项目页的演化展示重述;这里的叙述用于解释依赖关系,不是新增实验。
04长轨迹怎样才值得学
作者在 1,535 个环境上,用 DeepSeek-V4-Pro-0813 与 Terminus2 每题收集两条轨迹,经过程过滤后留下 2,852 条。环境覆盖 25 个专业领域,项目页进一步列出 463 个子领域。轨迹平均 52.82 轮,中位数 40 轮,P90 为 98 轮。
论文还报告了两个更接近“行为连接”的描述:最长连续终端反馈链的中位数为 25 轮;每条轨迹平均包含 8.6 类核心行为模式。它们补充了纯轮数统计,但仍是数据分析指标,不能独立证明每一轮都有训练价值。
| 维度 | 检查什么 |
|---|---|
| 轨迹有效性 | 上下文与动作—观察对应关系可解释;排除严重损坏、答案泄漏、状态篡改或绕过规定接口。 |
| 有环境依据的推进 | 文件、日志、错误与测试结果是否改变后续行动;排除长期忽略反馈和无根据的试错。 |
| 多轮训练价值 | 观察是否推动实现、判断、验证或恢复;等待、轮询和机械重复不因增加轮数而加分。 |
失败轨迹可以保留。一次未解决的任务,也可能包含可靠的根因定位和有证据的回退。成功轨迹则可能靠泄漏或绕过约束完成。附录 F 的评审器读取完整对话,不额外接收最终 reward 或成败标签;可恢复的命令、解析错误也不会自动导致整条轨迹被丢弃。
教师比较:为何选择 DeepSeek-V4-Pro?
在随机抽取的 100 个任务上,GLM-5.2 / DeepSeek-V4-Pro 的平均轮数为 46.1 / 53.5,平均反馈链为 19.2 / 30.3,完全重复动作比例为 15.8% / 13.2%,通过率为 44.0% / 50.0%。这些结果支持作者的教师选择,但没有把“教师身份”和“轨迹更长”分别做成可归因的训练消融。
这里的 53.5 轮来自教师对比的 100 题子集,与最终数据集的 52.82 轮统计范围不同。
依据:论文 §3、表 3、附录 F、J.1;领域细分与更精确的轮数见项目页。其他构造方法的轮数比较使用同一教师协议,每种方法采样 300 题;这不是它们各自训练后模型的同配置性能比较。
05先固定训练与评测口径
主模型是 Qwen3.5-27B,用这批多轮轨迹做全参数 SFT,训练 3 个 epoch。最大序列长度为 262,144 token,关闭 sequence packing,采用 BF16、AdamW、余弦学习率与 DeepSpeed ZeRO-3;峰值学习率为 1e-5。正文报告通常使用 18 个节点上的 144 张 H20-141GB GPU。
它强调按轨迹条数衡量的数据效率。每条轨迹很长,还包含环境生成、研究、独立挑战、重建、教师执行、评审与训练成本。论文没有给出足以直接比较各方法全流程成本的统一账单,因此不能把“条数少十倍”直接写成“总成本少十倍”。
Terminal-Bench 使用 Harbor 与 Terminus-2 JSON parser,每题上限 3 小时,每题独立运行 3 次,报告平均 pass@1。这里的 3 次用于估计单次通过率,不是三次里成功一次就算通过的 pass@3。评测的上下文窗口为 262,144 token,并启用 harness 的主动摘要;成绩描述的是模型与这套执行配置的整体表现。
依据:论文 §4.1、附录 A.1–A.2。TB 2.0 的 Base=41.6 来自官方模型卡,表 1 特别标记,须与按本文协议测出的基线区分。
06结果解读:12 个基准,为什么有 13 行
计数是 3 个 Terminal-Bench 版本、4 个 Agentic 基准组,以及 5 个推理基准,共 12 个。AutomationBench 同时报告“所有断言都通过”和“通过了多少断言”,因此表中出现 13 项指标。下面保留项目页与论文的原始分数,不把不同指标平均成一个总分。
| 基准 / 指标 | Base | SFT 后 | 提升(百分点) |
|---|---|---|---|
| 终端任务 · 3 个基准 | |||
| Terminal-Bench 1.0 | 46.3 | 55.0 | +8.7 |
| Terminal-Bench 2.0 † | 41.6 | 55.8 | +14.2 |
| Terminal-Bench 2.1 | 46.82 | 60.67 | +13.85 |
| Agentic · 4 个基准组,5 项指标 | |||
| AutomationBench · Pass Rate | 5.5 | 17.2 | +11.7 |
| AutomationBench · Partial | 26.4 | 49.7 | +23.3 |
| τ²-bench · Airline | 79.0 | 84.5 | +5.5 |
| τ²-bench · Retail | 84.9 | 87.5 | +2.6 |
| VitaBench · Cross-domain | 20.5 | 31.8 | +11.3 |
| 通用推理 · 5 个基准 | |||
| MATH-500 | 96.9 | 98.9 | +2.0 |
| GSM8K | 96.3 | 97.3 | +1.0 |
| AIME 2024 | 93.3 | 96.7 | +3.4 |
| AIME 2025 | 86.7 | 93.3 | +6.6 |
| KOR-Bench · Cipher | 90.1 | 91.2 | +1.1 |
百分点 = 新分数 − 原分数。TB 2.1 提升 13.85 个百分点;相对原分数的提升约为 29.6%,两者不能互换。
来源:论文表 1–2 与项目页 Results。† TB 2.0 基线取自官方模型卡。其他评测的重复次数、judge 与解码设置见附录 A.2,不统一称为同一种 pass@1。
一,最直接的收益在终端任务
TB 2.1 从 46.82 到 60.67,说明这套数据在作者的执行配置下能改善模型完成终端任务的能力。表 1 中,使用相同 Qwen3.5-27B 基座、同为 Terminus2 的 Terminal-Universe-27B,在 TB 2.0 为 52.8;TerminalHorizon 为 55.8,训练轨迹约 3K 对 32K。这是有参考价值的数据效率比较,但训练 recipe、token 总量和生成成本并没有因此被完全控制。
二,跨接口迁移比只涨 Terminal-Bench 更有信息
训练数据来自终端,AutomationBench、VitaBench 与客服场景仍出现收益,支持“学到的经验可以迁移到其他交互任务”这一解释。尤其 AutomationBench 的 Partial 从 26.4 到 49.7,反映更多评分断言完成;Pass Rate 从 5.5 到 17.2,则说明严格完成仍有很大改进空间。17.2% 不能因相对增幅大,就被描述为已经可靠自动化。
三,推理能力没有在这些评测里明显退化
五个推理基准都上升,支持“这次 SFT 没有以所测通用推理分数为代价”的结论。它尚不足以证明所有通用能力都被保留。AIME 每年只有 30 题,即使重复三次估计均值,题目覆盖仍小;不能仅凭几个百分点就判断已经稳定提升了同等幅度的推理能力。
07数据和模型放大后,收益怎样变化
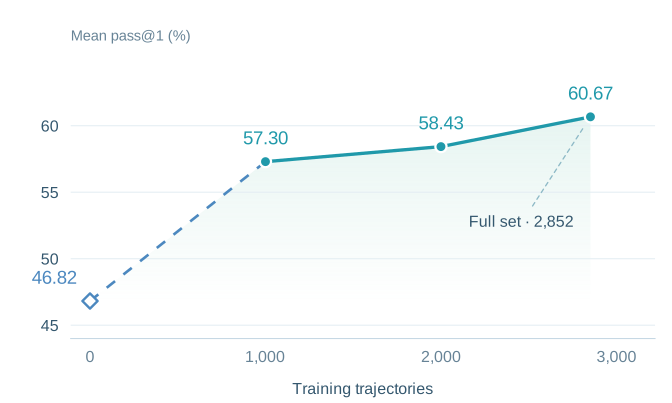
交互阅读:看累计收益,也看每段新增收益
只展示四个已报告的数据点,不插值预测更大数据集。
| 训练轨迹数 | TB 2.1 | 比 Base 多(百分点) |
|---|---|---|
| 0 | 46.82 | — |
| 1,000 | 57.30 | +10.48 |
| 2,000 | 58.43 | +11.61 |
| 2,852 | 60.67 | +13.85 |
前 1,000 条带来 10.48 个百分点,占最终累计提升的约 75.7%。后面仍有收益,但四个点无法确定更大规模时的曲线形状。
1000 → 2000 条新增 1.13 个百分点;2000 → 2852 条新增 2.24 个百分点。后两段的样本增量并不相等,也未报告多种子置信区间。作者据此认为未见饱和;更谨慎的理解是:已测范围内最高分仍随数据增加而提高,还无法拟合稳定的 scaling law,或保证继续增加同类轨迹仍有同等收益。
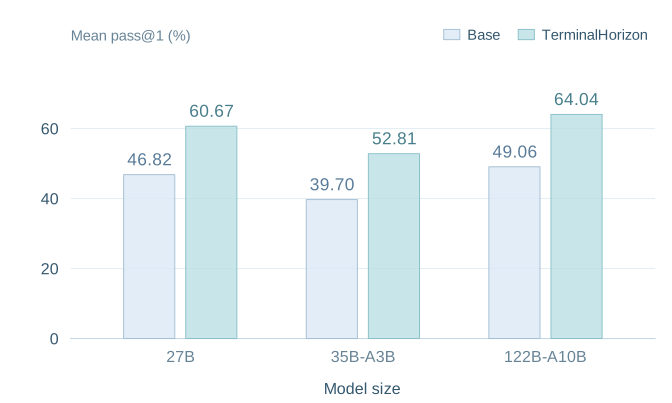
三个 Qwen3.5 配置都改善,说明训练价值不限于 27B 这一种配置。它们包括 dense 与 MoE,不能只按名字里的总参数直接推断计算量。35B-A3B 的 Base 低于 27B,也说明这里不是控制其他条件后测出的单一参数规模规律。
依据:论文 §4.3、附录 A.1 与项目页的数据规模、模型规模图。附录说明三种模型使用同一组 SFT 超参数,报告训练 3 个 epoch 后的最终 checkpoint。
0812 小时案例:持续改进,还要交付正确版本
RSI-Exam 的四个案例比较了相同研究预算下的行为。两种模型各有 12 小时,允许提前结束;研究期间看不到隐藏评测结果。最终评分针对实际提交的实现,不是事后替模型挑出的历史最优 checkpoint。
| 案例 | Base | SFT 后 | 分数差 | Base 用时 |
|---|---|---|---|---|
| 机器人路径与宏优化 | 14.63 | 39.72 | +25.09 | 11.42 h |
| 潮汐海床摩擦反演 | 27.41 | 48.15 | +20.74 | 1.12 h |
| 2048 策略优化 | 37.54 | 45.25 | +7.71 | 1.28 h |
| 多视角点云融合 | 21.93 | 48.96 | +27.03 | 约 12.1 min |
来源:论文表 5、附录 C。TerminalHorizon 四例均用满 12 小时;时间不含环境准备与最终验证。表中差值是归一化分数差,不是任务成功率或相对百分比提升。
点云案例:先怀疑“高分”是否测对了东西
Base 用第一视角附近的点构造了一个很高的自定义代理指标,却可能漏掉只在其他视角可见的表面。TerminalHorizon 也遇到过类似诱惑,但进一步检查点来自哪些视角,并用 leave-one-view-out 诊断发现覆盖问题,随后修改对齐、全局优化与置信度筛选策略。
官方隐藏集的原始几何 F-score(按 0–100 展示)为 48.04 → 77.68;另行校准的归一化分数是 21.93 → 48.96。+27.03 指后者的分数差,不能写成几何 F-score 上升了 27.03,或模型研究时直接看到了这个隐藏分数。
机器人案例:中间做得好,最后仍可能交坏
Base 的公开集最佳平均按钮成本曾到 286.05,但后续修改移除了宏压缩,最后提交退化到 466.35。TerminalHorizon 最终为 281.11,保留了已验证的压缩收益。这个例子值得关注的是最终版本管理:长期工作还包括拒绝回归、保存最佳方案和核对交付物。
另两个案例分别展示了用鲁棒损失和更合适的空间表示改进反演,以及在 2048 搜索中修复缓存失控、回退局部集上好看但全量退化的候选。它们帮助解释作者说的“持续工作”是什么。
它们提供了可追溯的行为证据,但每例每模型只有一次研究运行。相同预算下 Base 提前结束,也是整体策略表现的一部分;然而没有额外控制实际计算量,也没有“强制 Base 用满 12 小时”的对照,不能将全部分数差单独归因于更好的诊断策略或更强的耐心。
09证据边界:还缺哪些实验
最稳妥的结论:这套构造、采集、筛选与 SFT 的整体方案,在作者报告的配置下改善了所测模型与指标。进一步解释“为什么有效”,需要把混合在一起的因素拆开。
- 长度与内容没有被单独控制。更长的轨迹同时可能包含更多 token、更丰富的领域、更强教师与更完整的验证;没有等 token 预算的短轨迹对照,就无法断言长度本身产生收益。
- 两个构造阶段缺少独立的下游消融。正文没有给出完整的“去掉独立挑战 / 去掉渐进扩展 / 两者全开”的同条件训练矩阵,因而无法分别量化贡献。
- 更多轨迹不等于更多独立任务。2,852 条轨迹来自 1,535 个环境,且存在父任务与扩展任务的关系。研究数据划分时应关注任务家族,不能仅凭轨迹条数判断多样性。
- 小幅收益需要不确定性信息。重复评测有助于估计均值,但表格未给出完整置信区间与训练种子方差,尤其不应过度解释高基线上的一两个百分点。
去污染做了什么,是否等于彻底排除记忆?
作者将 1,535 个训练任务与 3,251 个评测实例的完整题面比较,使用规范化全文、13/14-token 连续片段、5-gram Jaccard、TF–IDF 和保留数学结构的 8-gram 检索。合并后审查 190 对候选,未发现被判为污染或不确定的任务对。
这支持“在所检查的题面与候选中未发现任务复用”。它不审计基座或教师的全部预训练来源,也不是对任意语义改写都能召回的证明。这里应沿用作者检查的范围,不将其写成零污染保证。
依据:论文 §4.3、附录 G;缺失实验与因果解释范围是本站的阅读判断,不是作者额外报告的负面结果。
10放进环境与训练流水线,先落地什么
下面是基于论文的工程建议,不代表本站已经接入这些数据,或验证了它与某种 RL 算法组合后的收益。
- 检查“真正留给求解者的工作”。为任务保留公开要求与独立执行证据,审核关键实现、答案和诊断是否已经存在于初始文件中;发现捷径时先区分真实高效解法与环境提前完成。
- 记录完整任务谱系。保存父任务、扩展方向、构造版本、验证器版本和挑战记录。划分训练与验证集时优先按任务家族检查隔离,避免同题轻改版本跨集合。
- 把过程质量与最终 reward 分开。SFT 选择可模仿的演示,RL 需要可信的奖励与环境状态;失败但有效的诊断可以帮助前者,不能因此擅自更改后者的成功定义。
- 长轨迹接入前先核对格式与截断。检查工具协议、assistant 训练 mask、观察对应关系、摘要与上下文重建。只保留最后成功动作,可能恰好删掉论文希望训练的跨阶段依赖。
- 小规模对照后再扩大。固定基座、harness、评测与 token 预算,比较现有数据、TerminalHorizon 数据和混合数据;同时记录成绩、失败类型、生成成本与执行时间。若进一步做 RL,另行验证 reward 可靠性与在线训练稳定性。