T1:用"通过断言的绝对数"做稠密奖励,用满血 critic 做唯一基线
腾讯混元团队把一个 122B(激活 10B)的 MoE 模型放进真实 shell 沙箱里跑 PPO,单任务最多 300+ 轮工具调用。论文最有信息量的部分不是榜单,而是他们如何把 verifier 的逐条断言结果变成 reward、以及一个与 actor 同尺寸的 critic 是怎么被调稳的——包括那些没做成的尝试。
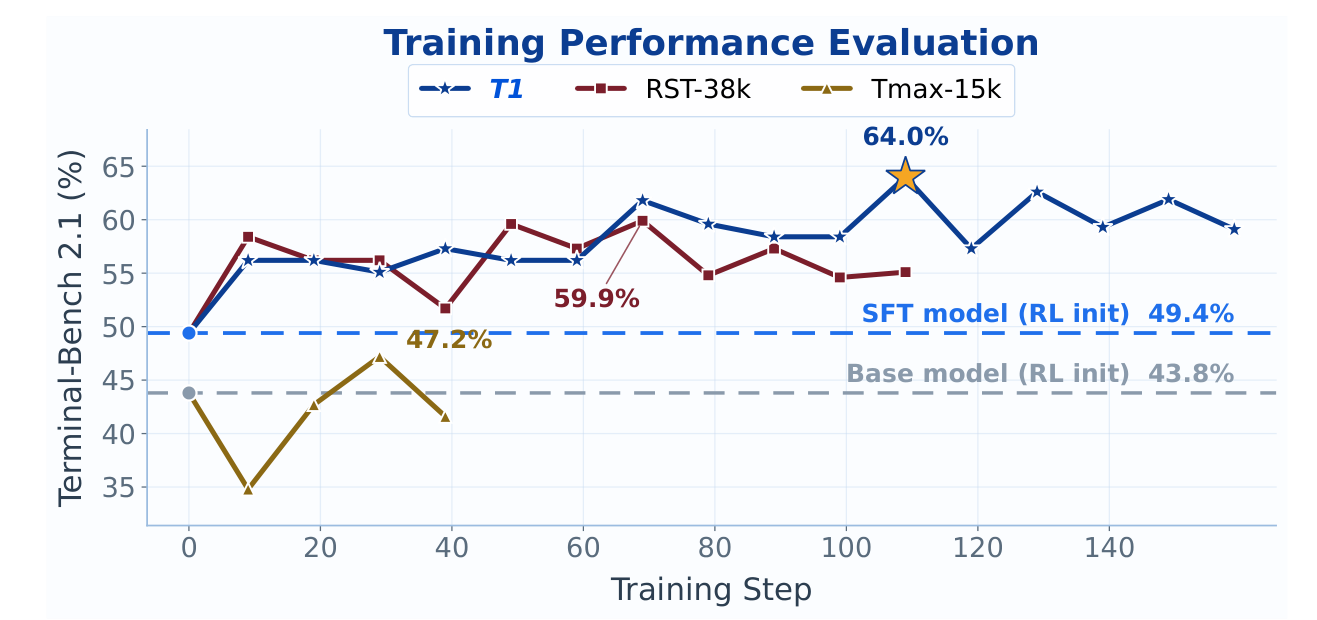
一句话:Reward 取"通过的断言数 ÷ 固定常数 20"而不是通过率,只打在轨迹末 token 上、不做任何归一化;时间上的功劳分配全部交给一个预热过、学习率高 15 倍的满血 critic。这套组合把 SFT 检查点的 Terminal-Bench 2.1 从 49.4% 推到 64.0%,而同样的数据用 GRPO 训不动。
- 二值 reward 训不动:第一次 binary-reward 战役(TMax-15k,冷启动 critic)从 43.8% 涨到 47.2% 后再也没超过 SFT 的 49.4%。它唯一留下的资产是一个训过的 critic。
- 稠密 reward = 绝对通过数 / 20:不是比率。难任务配更多断言,10/20 得 0.5 而 2/4 只得 0.1;固定分母让 critic 的回归目标跨 step 稳定,也堵住"靠一条极端样本改整批尺度"的操纵路径。
- Critic 是唯一 baseline:每任务每步只采 1 条轨迹,没有组内统计可用;reward 不归一化,GAE 取 γ=λ=1,回报分段常数,value 问题退化为"从前缀预测这条轨迹最终得几分"。
- Critic 预热是关键:冷启动 critic 的 explained variance 开局 −33.6,58 步里 30 步为负;预热后从第一步就在 0.71–0.86。critic lr 1.5e-5 vs actor 1e-6。
- 但 critic 校准好 ≠ policy 变好:27B 探路实验里把 EV 提前转正,reward 却纹丝不动——问题在 verifier 给不了部分进度信号,而不在优化器。这是他们转向稠密 reward 的直接原因。
- 结果:Terminal-Bench 2.1 43.8(base)→ 49.4(SFT)→ 64.0(RL),RL 贡献了总增益的 72%;Long-Horizon TB 18.9 → 27.9;TB-Hard 20.0 → 38.0。同 harness 下超过 GPT-5.4(54.8)、DeepSeek-V4-Flash(56.9)、Opus 4.6(63.8)。
01论文在做什么
T1 是一个纯靠"执行结果"做 RL 的终端 agent:任务是一个自包含的目录(指令、Docker 环境、资源限制、held-out verifier、参考解),agent 在云沙箱里逐轮发 shell 命令、读输出,直到完成或耗尽预算,然后 verifier 跑一遍,把每条断言的通过/失败写成结构化报告(CTRF)。这份报告就是 reward 的唯一来源,没有任何 reward model。
论文自述的三块贡献:
- 稠密 verification reward(第 5 节):按通过断言的绝对数计分,外加两个失败的 shaping 变体。
- MoE 大模型 agentic RL 的稳定栈(第 4 节):TITO(token-in-token-out,训练侧直接消费采样时的 token id)+ R3(rollout routing replay,训练时重放采样时的专家选择)+ 有调度的 critic。训练–推理 log-prob 差从 0.021 降到 0.013,loss 区域内 token 漂移精确为零。
- 完全 OOD 的训练集(第 3 节):合成任务与 Terminal-Bench 2.1 无交集,涨分来自能力迁移而不是刷榜。
训练框架是一步异步的 PPO:推理副本和训练后端各占一批 GPU,step t 训练与 step t+1 采样并行;每步过采样 560 条轨迹、收前 512 条就截断长尾;每步约 57 分钟,其中约 16 分钟采样被约 41 分钟训练完全遮住。上下文 84k,T1-15k 上跑 3 个 epoch,第 110 步取到最优。
02Reward 设计从数据合成就开始了
论文有一句很准确的话:"No reinforcement signal can be richer than what its verifier can measure." 三个训练池的差别正好说明这一点:
| 训练池 | 规模 | verifier 粒度 | 用途 |
|---|---|---|---|
| TMax-15k | 14,601 | 只有二值结果,没有逐断言记录 | 只能做 binary reward;后来用来预热 critic |
| RST-38k | 37,484 | 逐断言 | 未过滤的合成池,dense reward 训到 59.9% |
| T1-15k | 15,000 | 逐断言(抽样 93% 的任务确认有记录) | 生产 run,训到 64.0% |
RST(Recursive Synthesis for Terminal tasks,同一团队的前作)在合成任务时就刻意给每个任务配足够多、覆盖各个子需求的断言,而且难任务配更多断言、每条断言大致对应可比的工作量。这是后面"绝对数而非比率"这个 reward 决策的前提假设。
LLM 审计:verifier 质量占 45% 权重
T1-15k 是 RST 合成轮次里经 DeepSeek-V4-Pro 语义审计存活的子集。八个维度里,"指令与 verifier 对齐"权重最高(20%),理由直白:verifier 强制要求了指令里没写的东西,就是隐藏需求,agent 会因为一个它从没见过的标准被罚。按方面聚合:verifier 45%、solution 25%、instruction 20%、任务训练价值 10%。四种情况直接 hard reject:隐藏需求、测试泄漏、解法捷径、verifier 弱到验不了任务目标。
15 个改写轮次、五个阶段筛选,语义审核一轮的结果是 5,902 通过、3,251 边界、5,847 拒绝,另有 6,875 个任务做了"只改指令"的修复后再审。
论文在 5.4 节明确说,数据侧审计是"唯一针对任务可利用性的防御"。verifier 在 agent 可控的沙箱里跑,没有运行时防篡改(只读挂载、校验和都列在 future work)。也就是说,防 hacking 的责任几乎全部前移到了造数据的阶段,而不是 reward 函数本身。
03Reward 设计(重点)
3.1 为什么从 binary 换成 dense
动机是纯经验的:刚在 T1-15k 上跑 RL 时,很多任务模型根本做不完。binary reward 下这些轨迹全是零,哪怕已经满足了一部分需求。完全成功太稀有,部分进度又完全不可见。一批 rollout 要烧几百个沙箱小时,换回来每条轨迹一个 bit——第一次 binary 战役从头到尾没超过 SFT 基线。
3.2 定义:绝对通过数 / 固定常数
论文强调了三个决策,每个都带理由:
绝对数,不是比率。训练池混合难易任务且不做课程、随机打散,一个 batch 里难易都有,所以跨任务的 reward 尺度是实打实要紧的。难任务过 10/20 和易任务过 2/4 的通过率都是 0.5,但前者可能要长得多的工具交互链。用 S=20 统一尺度后分别得 0.5 和 0.1,每多过一条断言固定加 1/20,"难任务上多做几步"和"易任务上少做几步"的差别被保留下来。
全局固定尺度。S=20 是量了 T1-15k 断言数分布之后定的:中位数 4,最大约 35,20 大约在第 90 百分位。之所以不用 per-batch 最大值做分母,是因为那会让 reward 尺度逐步漂移,critic 拿到的回归目标每步都不一样;跨 step 一致性正是 value function 可学的前提。
回退。逐断言报告缺失或解析失败时,退回二值终态结果 b,保证"真解出来的任务永远不会得零分";解析失败按原因打标签便于观测。
另外保留了一个早期的比率版变体用于对照:r = max(b, 0.4·P/T),截断到 [0, max(1, b)],T 是断言总数。生产 run 用的是式 20。
3.3 Reward 实际长什么样
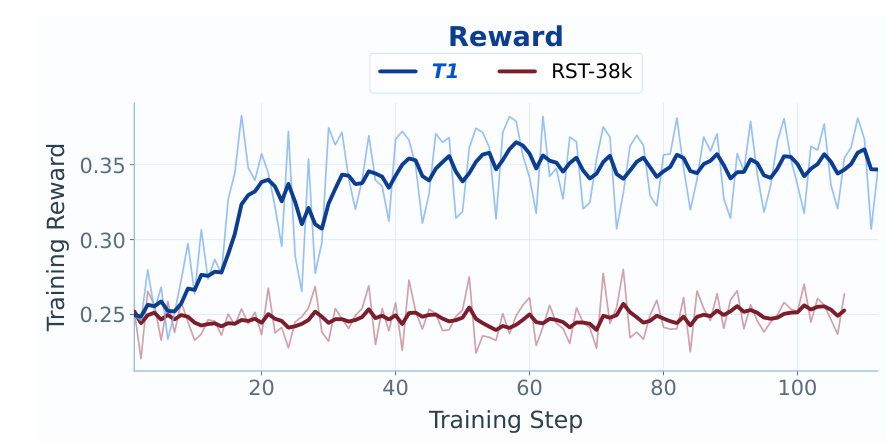
几个值得读出来的点:
- 均值 0.35 ≈ 每条轨迹平均过 7 条断言,落在信号的分辨率区间内,既没贴 0 也没贴顶。比率版会把每个任务都压到 1.0 封顶,这个区分度就没了。
- 平台期不是停滞:reward 平了 60 步,held-out 榜单还在涨(第 70 步 61.8%,第 110 步 64.0%)。论文的解释是模型在重新分配"过哪些断言"而不是单纯多过几条。
- 高频振荡是 shuffling 的签名:batch 512、每任务一条样本,振幅约 0.02 全程恒定,不是不稳定。
- RST-38k 未过滤池训到 59.9% 后停滞,reward 曲线也基本不动——同样的 reward 定义,数据质量决定了信号能不能被吃到。
3.4 Credit assignment:时间上的功劳全交给 critic
论文特意区分了两种"稠密":式 20 的稠密是值域分辨率上的(每条断言 +1/20),不是时间放置上的。整条轨迹(含所有 chunk)只在最后一个 response token 上收到一个标量。由此两条推论:
- 时间上的 credit 来自 value function。GAE 取 γ=λ=1 把终末标量向前传播,不加任何 potential-based shaping 或逐轮项。
- Reward 不做归一化。每任务每步只有一条轨迹,不存在组内统计;而且 advantage 归一化会把"绝对通过数"刻意保留的跨任务差异重新抹平。
结论就是那句 "The critic is thus the only baseline"——critic 校准从此进入关键路径,这也是第 04 节的全部动机。
3.5 防 reward hacking:数据侧 + reward 侧 + shuffling
- 数据侧:上面说过的 hard reject 四条。
- 长度监控:计数型 reward 天然有"多跑几轮多过几条测试"的激励。27B 实验里确实出现了轮数失控增长,他们试了多种长度 shaping 变体;其中加性长度惩罚反而导致超过 50 轮的无界增长。122B 生产 run 密切监控轮数与序列长度,没再出现失控,于是长度 shaping 直接关掉,用最朴素的计数 reward。
- 固定 S:per-batch 归一化下一条极端样本就能改变整批的分母;固定分母使每条轨迹的 reward 与其他样本无关。
- Shuffling 是 reward 设计的一部分:T1-15k 按质量排序落盘,如果顺序读,batch 512 会集中在一个窄质量带里,critic 看到的 reward 分布会在 epoch 内单调漂移。所以每 epoch 带种子重排是强制的。
- 它假设"一条断言 ≈ 一单位工作"跨任务成立。论文自己承认这只是合成时的近似原则,不是保证。断言数不是靠增加难度而是靠 verifier 写法膨胀的任务,会被系统性高估。
- r 无上界且不归一化,critic 承受全部尺度压力。一个 35 断言的任务能给出 1.75 的 reward,而中位任务只有 0.2 的满分。这在 PPO 里没问题(critic 能学绝对值),但它进一步解释了为什么 GRPO 在这里失效:组内标准化会把这些差异全部抹掉。
- 论文没有做单变量 reward 消融:binary vs dense 的对比是"战役级"的,reward、数据池、初始化、routing replay 同时变了。这一点他们在 Limitations 里写得很坦白。
04Critic 设计(重点)
4.1 一个与 actor 同尺寸的满血 critic
Critic 是同架构的第二份 122B 拷贝,只把最后 pipeline stage 的语言模型头换成标量 value head。它不额外占卡,与 actor 分时复用同一批设备,训练侧强制 offload,因此两个网络各自必须单独塞进 95 GiB——这是第 7 节整套容量模型的约束来源。
4.2 更新顺序与目标函数
每步 critic 先更新,把更新前的 value Vold = Vφt−1 交给 actor,让 advantage 估计和 value clip 都锚在同一个固定函数上:
把 GAE 和 ±0.2 的 value clip 锚在 Vφt−1 而不是训练中的 Vφt,让 value clip 真正成为一个围绕固定函数的信任域(附录 B.4)。
4.3 Critic Warm-Up
做法很朴素但效果决定性:在 TMax-15k 上先跑一个 epoch 的 actor-critic 训练,只保存 critic 权重,policy 步骤一步都不用。生产 run 加载这些权重时只加载权重、不带优化器动量(避免跨 run 的状态污染),然后只需要 2 个 re-calibration rollout 就能对齐。对照组是 binary 战役的冷启动 critic。
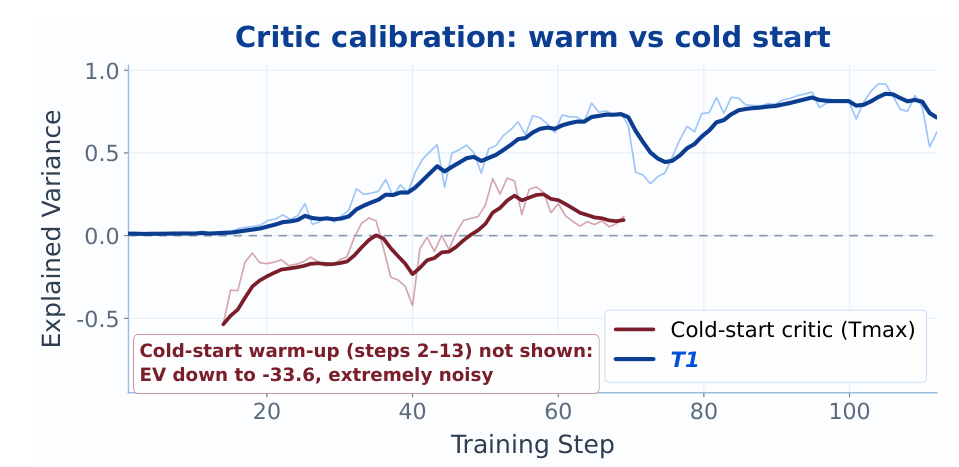
冷启动 critic 大约用了半个战役来偿还这个初始亏空——这个时间窗口正好对应 binary 战役"涨到 47.2 后再也不动"的阶段。
4.4 学习率:critic 比 actor 高一个数量级
| 参数 | 值 | 相对 canonical(5e-7) |
|---|---|---|
| critic lr ηφ | 1.5 × 10⁻⁵ | 30× |
| actor lr ηθ | 1.0 × 10⁻⁶ | 2× |
| critic / actor | 15× | |
摘要里写的"critic trained at 30× the actor learning rate"与附录 Table 3 的定义(ηφ=30ηcanon,ηθ=2ηcanon)不一致,按具体数值算是 15 倍。理由是 critic 的目标是监督回归而不是 policy improvement,能吃更大的步子。27B 探路实验里把这个比例从 10× 提到 20×,EV 从 −39 提到 +0.11;30× 进一步缩短了预热时间。
4.5 让 value 目标"好回归"的两个条件
论文把这叫 value-target conditioning:
- reward 用全局固定尺度(S=20),目标分布跨 step 稳定;
- reward 只落在末 token 且 γ=λ=1,于是每条轨迹的逐 token 回报是分段常数,value 问题退化成"从前缀预测这条轨迹最终得几分"。
这实际上是把 critic 变成了一个"进度预测器":给定到目前为止的交互历史,估计最后会过几条断言。它不需要预测任何中间奖励,也没有折扣衰减,这大概是 122B critic 能在 EV 0.7+ 稳定工作的原因。
4.6 Critic 不做 routing replay
R3 只用在 actor 上。Critic 的目标是对回报的监督回归,不需要对采样策略保持行为保真,所以它自由选专家(φt−1, TopKk)。此外 critic 的 batching 方式不同,强行共享 buffer 会破坏"token 与路由记录同分片"的不变量。
4.7 为什么不用 GRPO:三条都与长程有关
在确定用 PPO 之前,他们在同样的 harness、reward 和设备预算下跑了 GRPO。结果是 reward 无趋势地波动,第 10 步和第 20 步的 held-out 评测完全一样:51.7%,都是 89 题里的 46 题。
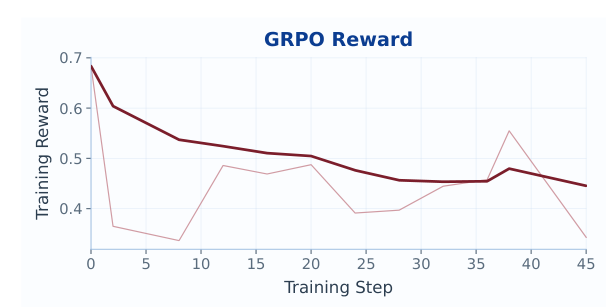
- advantage 恰好在需要信号的地方退化。组内标准化 Ai=(ri−μ)/σ,全失败或全成功的组贡献零梯度;在难到需要稠密 reward 的任务上,这种组是常态,少数有方差的组主导更新。而且一条轨迹所有 token 共享同一个 advantage,GAE 提供的时间 credit 没了。
- 组大小和任务多样性在长程任务上互斥。每个任务要采 G 次才换来一个 advantage,固定采样预算下每步不同任务数按 G 倍缩水。PPO 用 critic 提供 baseline,同样的预算全花在不同任务上。
- 重复采样的代价在长尾上结算。一个组要等最慢的成员结束;终端轨迹在轮数和 token 上都是重尾,独立 trial 可以截尾,组内不能(截了比较就没了)。采样端在这个估计器最需要的配置上空转。
论文的总结:组 baseline 是 value function 的替代品,单轮场景下便宜,代价随 horizon 增长;critic 的代价真实但有界。
4.8 教训:critic 校准好不代表 policy 会变好
这是第 9 节第一条,也是我认为全文最有价值的一段。27B 探路实验里,提高 critic lr 把首次 EV 转正从第 50 步提前到第 30 步,rollout reward 在各设置间纹丝不动。critic 在更好地预测回报,actor 拿到的 reward 没变。
原因:critic 学的是 reward 函数分配的回报。难任务大多拿同一个零,预测得再准也不能揭示 verifier 从没奖励过的部分进度。任务池和 reward 粒度决定哪些改进可观测;critic 校准决定 baseline 对这些回报建模得多好。两者要分开诊断:EV 是关于 value function 的证据,通过测试数、任务完成率、held-out 评测才是 policy 是否在进步的证据。校准在涨而 reward 不动时,该看的是任务难度和 verifier 粒度,而不是继续调优化器。
| Reward 侧决策 | 对 critic 的意义 |
|---|---|
| 绝对数 / 固定 S=20 | 回归目标跨 step 同尺度,value 可学 |
| 只打在末 token,γ=λ=1 | 回报分段常数,value = 预测最终分数 |
| 不归一化,每任务 1 样本 | 没有组 baseline,critic 是唯一 baseline,校准进入关键路径 |
| 每 epoch shuffle | critic 看到的 reward 分布平稳,不随质量排序漂移 |
| 逐断言粒度(数据侧) | 让"部分进度"可观测;critic 再准也补不回 verifier 没给的信号 |
05稳定栈简述:TITO 与 R3
这部分不是本文重点,但要理解为什么他们的 PPO 敢关掉 KL,得知道它。核心观察是:PPO 的重要性比 rj(θ)=πt/πt−1 只有在分母能被训练侧精确复现时才有意义。有两个东西会破坏它:
- Token 保真:harness 把每轮 assistant 输出存成文本、下一轮重新走 chat template 编码,enc(dec(a)) 不一定等于 a。TITO 让训练侧直接消费采样时的 token id,轮边界上按"严格前缀 → 有界修剪(97×17 网格)→ 文本等价回退 → 切分新 chunk"四级修复。审计 1,402 条样本,loss 区域内漂移率 0.0000%。
- 路由保真:48 层、每层 256 选 8 的 top-k 是不连续的,两套 kernel 极小的数值差就能换掉一个专家,比值就在比较两个不同的子网络。R3 记录采样时每个位置每层的专家选择(每 token 1.5 KiB,rollout 开销 <3%),训练时只重放选择、softmax 仍在当前 logits 上算,router 保持可训练。
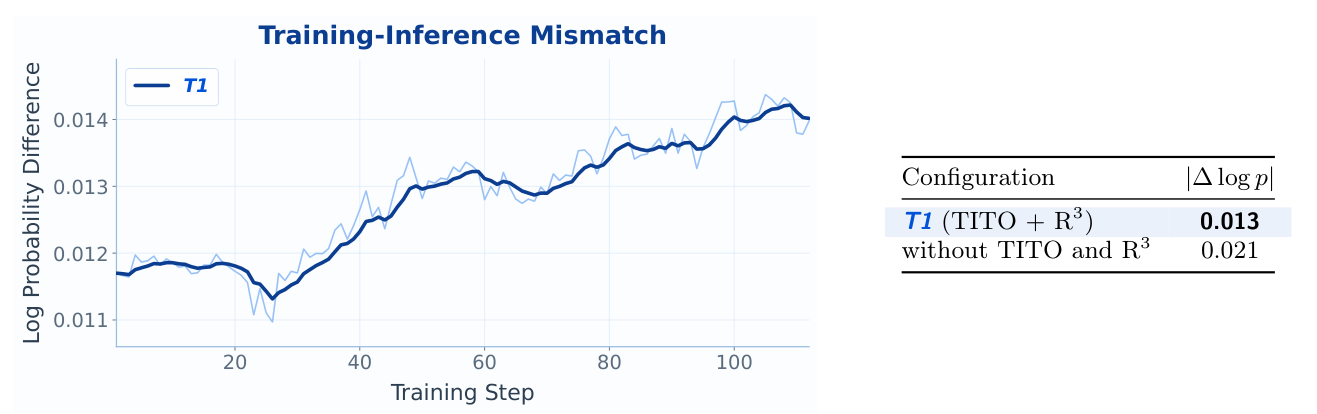
由此带来的 PPO 配置:对称 clip ε=0.2;两个 KL 项都关掉(冻结的参考模型用自己的路由,会为簿记差异冤枉 policy);MoE 负载均衡系数置零(均衡压力要求 router 重新分配的恰是 replay 要求它复现的);Adam β=(0.9, 0.98)、weight decay 0.1、常数 lr;batch 560 过采样收 512。
06主结果与训练动态
| 模型(同 harness:Harbor/Terminus-2) | 规模 | TB 2.1 (%) | LHTB |
|---|---|---|---|
| Claude Opus 4.7 | / | 66.1 | – |
| T1 | 122B-A10B | 64.0 | 27.9 |
| Claude Opus 4.6 | / | 63.8 | – |
| Muse Spark | / | 62.2 | – |
| Qwen3.5-122B + RL (RST-38k) | 122B-A10B | 59.9 | 25.4 |
| Hy3-Preview | 295B-A21B | 58.0 | – |
| DeepSeek V4 Flash (high) | 295B-A21B | 56.9 | – |
| Kimi-K2.5 | 1040B-A32B | 56.4 | – |
| GPT-5.4 | / | 54.8 | 27.2 |
| Claude Sonnet 4.6 | / | 51.5 | 37.3 |
| RST-SFT(RL 起点) | 122B-A10B | 49.4 | 23.6 |
| Qwen3.5-122B + RL (TMax-15k, binary) | 122B-A10B | 47.2 | 20.3 |
| Qwen3.5-122B-A10B (base) | 122B-A10B | 43.8 | 18.9 |
Harness 对分数影响很大:Opus 4.6 在 Claude Code 下是 70.1,Terminus-2 下 63.8;GPT-5.4 在 Codex CLI 下 77.3。T1 是专门为 Terminus-2 训的,对比模型不是。LHTB 是平均 reward 而非解决率,且排序与 TB 2.1 并不一致(Sonnet 4.6 在 LHTB 上 37.3 远超 T1)。
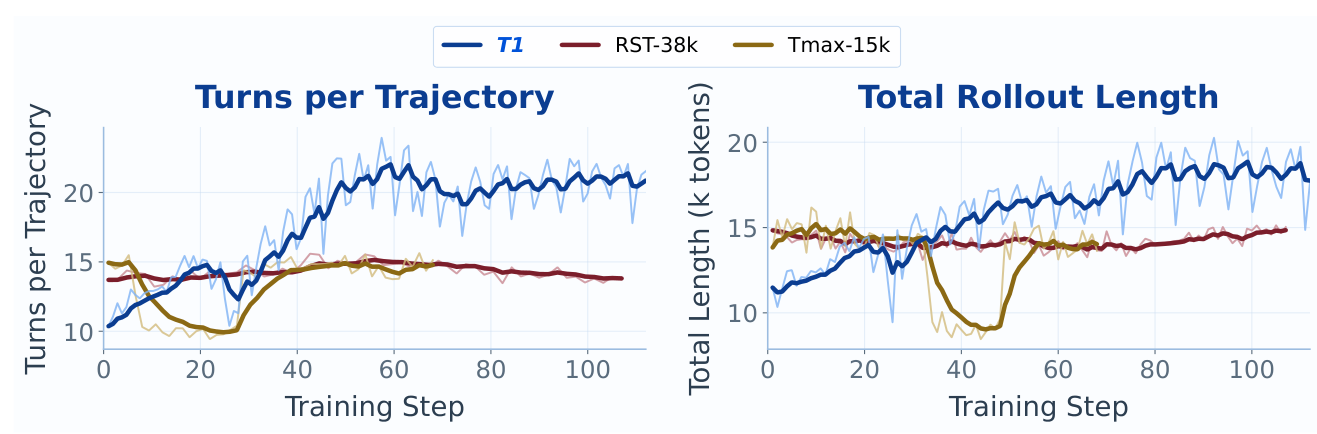
增益落在哪里:Easy 组三个检查点都是 100%;Medium 组 56 → 58 → 78;Hard 组 20 → 30 → 33。RL 的提升主要在 Medium。评测时 T1 平均用 94.4 轮,SFT 31.5、base 41.1——成功率的提高是用大约 3 倍的交互换来的。六个代表性失败案例里 T1 花 164–473 轮后超时,GPT-5.6 Sol 只用 6–40 轮;论文自己的判断是"更长的交互只有配上有效的诊断、恢复和停止决策才有用,单纯加轮数预算解决不了"。
附录的两个 case 很直观地说明 RL 改变了什么:build-pov-ray 里 SFT 模型在总结里准确诊断出"下载源已死、该换镜像",却继续重试同一个死链接直到 51 次上下文溢出;T1 得出同样诊断后换了 FTP 镜像,65 轮零溢出通过。polyglot-c-py 里两者都写对了 polyglot,差别只是 T1 在收尾前删掉了编译产物,让目录恰好只剩 main.py.c。RL 改的不是推理能力,是"放弃失败假设"和"把最终机器状态当交付物"这两个行为。
07没做成的事与局限(论文自述)
- 上下文管理决定 agent 能学到什么(9.2):一次战役里上下文预算与摘要长度配置不匹配,98.3% 的全量摘要失败,回退只留一小段历史。agent 重复已完成的工作,平均轮数从 22 涨到 30,超时增多。训练照常产出轨迹和 reward,但 agent 是在记忆残缺下做决策。因此轮数增长本身是个歧义诊断:可能是有用的工作、reward 驱动的重复、或上下文丢失;对这种轨迹加长度惩罚只会掩盖记忆问题。
- Rollout 吞吐改变训练分布(9.3):过采样截尾在某一步里丢了 561 条中的 48 条,而"batch 已满"的计数器把这个损失藏起来了。被截掉的不是均匀样本,集中在最难的任务族。对稠密 reward 尤其致命:难任务上的部分进度只有在轨迹活到被验证时才有用。最难的长尾被付了两次钱——训练时被截掉,评测时正是这些任务失败。
- 没有单变量 reward 消融:binary vs dense 的证据是战役级的。
- verifier 完整性靠过滤,不靠强制:沙箱内无防篡改。
- TITO 只在 loss 区域精确:re-tokenized 情形下后续轮次的条件历史与推理时不同,影响 2.6% 的 token。
- 数据分布偏科:失败集中在 ML / 数据科学 / 科学计算,正是 T1-15k 覆盖薄的类别。
- 计划中但未实现:partial-rollout 续跑、难度感知调度、离线轨迹上的 critic value 预训练、HL-Gauss 分类式 value loss 以改善 step-0 EV、全异步 + SAT/GSPO 组合。
08值得带走的几点
- 先问 verifier 能测出什么,再谈 reward。T1 的 dense reward 之所以可行,是因为 RST 合成任务时就把"难任务多配断言、每条断言可比"写进了生成规则。TMax-15k 那种只给 0/1 的池子,reward 怎么设计都是一个 bit。
- 绝对数 + 固定分母,是为 critic 服务的选择。比率会封顶抹平难度差,per-batch 归一化会让回归目标漂移。若你的 baseline 是 learned value,reward 的跨 step 一致性比它"看起来是否在 [0,1]"重要得多。
- 长程 + 一任务一样本的场景,critic 是必需品,且必须预热。冷启动 122B critic 要花半个战役偿还 EV 亏空。用一份便宜数据先训 critic、只存权重不存优化器状态,是很便宜的保险。
- EV 和 reward 要分开看。EV 涨 reward 不动,说明 reward 粒度或任务难度出了问题,不是学习率。
- 轮数增长不要急着罚。先检查上下文压缩是否丢了记忆、截尾是否丢了难任务;T1 的加性长度惩罚反而导致无界增长。
- 关 KL、关负载均衡,只有在训推一致性被真正解决后才合理。TITO + R3 是这套"极简 PPO"能成立的前提,不能单独抄配置。