Score Centering:消除 Off-policy RL 的梯度漂移
采样和训练只差一点,为什么训练久了会崩?从一个“奖励永远为 1”的例子,看清模型究竟在跟着什么方向更新。
明明两个选择一样好,却因为生成数据的模型和训练中的模型不一致,训练仍然偏向了某个选择。Score Centering(SC)把这种无关的平均偏移扣掉,让更新更多地反映“哪个选择更好”。
选到一个 token 后,训练会把参数往哪个方向推、推多大?这个方向向量就是这里的 score = ∇θ log pθ(token | prefix)。它不是奖励分数,也不是 logprob 本身。SC 做的事,就是从每次的方向中减去“实际采样下的平均方向”。
01奖励都一样,为何还有更新
固定在同一个上下文,只能选 A 或 B。当前训练模型选择 A 的概率是 80%,B 是 20%;负责生成数据的旧模型却把 A、B 各选 50%。先假设两个选择收到的训练信号都为 +1,没有好坏区别。这里用奖励演示;实际训练通常乘的是 advantage,若它已被精确减到 0,这个例子中的更新自然也为 0。
第一步:两个选择一样好,模型却被推偏了
把“偏向 A 的程度”用一个参数 θ 表示,p(A)=sigmoid(θ)。常见的训练公式给出:选 A 时向 A 推 +0.2,选 B 时向 B 推 −0.8。先不用记推导,只看它们怎样抵消。这些数是参数的更新方向,不是把概率直接加减 20% 或 80%。
| 采样结果 | 更新方向(score) | 怎么理解 |
|---|---|---|
| 选到 A | 1 − p(A) = +0.2 | 增加偏向 A 的程度 |
| 选到 B | −p(A) = −0.8 | 减少偏向 A 的程度,也就是推向 B |
B 并没有更好,模型却平均被推向了 B。变化来自采样比例,而不是任务表现。这就是这里说的梯度漂移。−0.3 是解析期望;有限 batch 即使没有偏差,也可能有随机波动,不能凭一次非零更新诊断漂移。
第二步:把这个 −0.3 从每次更新方向里扣掉
实际采样下,更新方向平均偏了 −0.3。SC 就从每个方向里减掉这个数:
| 采样结果 | 原来的方向 | 减掉平均偏移后 |
|---|---|---|
| A | +0.2 | +0.2 − (−0.3) = +0.5 |
| B | −0.8 | −0.8 − (−0.3) = −0.5 |
无关的平均偏移消失了。如果 A 的训练信号更高,向 A 的方向会乘上更大的权重,模型仍然会学着选 A。例如 A 得 2、B 得 1,SC 的平均更新就是 50% × 2 × 0.5 − 50% × 1 × 0.5 = +0.25。
普通更新 = 训练信号 × 本次更新方向
SC 更新 = 训练信号 ×(本次更新方向 − 实际采样下的平均方向)
训练信号在实际算法中通常是 advantage;这里写的是梯度上升方向,最小化 loss 时符号相反。完整词表和精确采样分布下的期望可以精确中心化;后面的 top-k 实现则是近似。
它与奖励减均值、IS 各自改了什么?
| 方法 | 通俗理解 | 对应这个例子 |
|---|---|---|
| 奖励 / advantage 减均值 | 这次表现比平均表现好多少? | 改的是乘在更新方向上的训练信号 |
| 重要性采样(IS) | 给不同样本重新分配权重 | 让 50% / 50% 的数据,更新时表现得像 80% / 20% |
| Score Centering | 校正每次更新的方向 | 把实际采样下的平均偏移 −0.3 扣掉 |
精确 IS 已能消除这个单步例子的平均漂移;TIS 截断权重、DIS 屏蔽部分权重后,可能留下残余偏移,SC 可以与它们组合。组合时要中心化加权后的 score,不能简单把普通 SC 公式再乘一个 IS 权重。具体公式见第 05 节。
下面再把这个单步例子放回“训练端—采样端”的循环中:
用 q 产生的轨迹更新自己;正平均奖励下,漂移包含向 q 靠近的分量。
接收新权重,经过量化、不同算子或同步延迟后,再生成下一批轨迹。
固定教师的蒸馏与这个循环不同:教师固定时,学生有一个固定的拟合目标;在线 RL 中,采样端不断从训练端刷新,偏差可能跟着模型一起移动。论文据此解释持续误差为什么会累积。负平均奖励时,漂移方向还会反过来,因此“总是向采样端蒸馏”也不准确。
02把漂移与学习信号拆开
现在固定一个前缀 h。记 pᵥ、qᵥ 为这个前缀下两端的下一个 token 概率,sᵥ=∇θ log pᵥ,R 为后续轨迹的奖励或已停止梯度的优势。以下所有期望都以这个前缀为条件。
这只是协方差恒等式,但它把故障机制定位得很清楚:第一项只知道“奖励平均多大”,不知道“哪个 token 对应更好的结果”;第二项才区分奖励与动作的关联。真实任务中 R 还受后续动作影响,这个分解并没有声称一个 token 独自决定成败。
为什么 p=q 时不需要修正
这解释了 on-policy 情况下奖励平移不改变期望梯度。可是在 q 下,E_q[s] 通常不为零。给所有奖励加同一个常数 c,原始更新会多出 c·s̄,SC 更新则保持不变。稍后可以在交互例子中直接验证。
GRPO 式组内去均值为什么还不够
同一个 prompt 的一组优势相加为零,不等于走到每一个中间前缀后,条件期望优势也为零。例如“已经写出了正确关键步骤”的分支可能更容易成功,“已经走错方向”的分支则相反;两个分支的 s̄ 也不必相同。因此,组级平均抵消不了各个前缀下的漂移。
在这个前缀条件下,若恰好知道 b(h)=E_q[R | h],那么 E_q[(R−b(h))s] 也等于 Cov_q(R,s)。这是期望更新层面的对应关系;SC 无需学习这个 critic,但并不因此获得 critic 的其他能力,实际采样方差也未必相同。
SC 留下的是 Cov_q(R,s),而 on-policy 对应的是 p 下的量。动作分布、后续轨迹与访问前缀的分布都可能不同。尤其在异步训练中,不能由“条件漂移为零”推出“所有陈旧数据偏差都消失”。
对应原文 §4;关于访问前缀分布的提醒为解读者补充。
03交互:改变概率与奖励
下面对两个动作直接枚举求期望,显示梯度上升方向,不是 loss 的梯度。正值会增大 A 的 logit,负值会减小。它是一个单步教学模型,不是论文训练曲线,也不模拟长期收敛。
两个动作奖励相同,任务信号为零;原始更新仍包含采样偏差,SC 将其期望消除。
先点“A 更好”,再点“奖励整体加 1”:原始更新会变,SC 不变。再把 q 拉到 0.05,可观察 TIS 截断高比率后留下的漂移,以及组合校正的效果。这里的 TIS + SC 按完整双选项分布计算,没有 top-k 近似。
展开查看这个例子的解析式
在这个一维、单步、固定奖励的特殊例子中,SC 与 on-policy 的非零梯度同号,但大小可以不同;这不构成多维、长轨迹设置下的同方向保证。
04top-k 如何近似整个词表
完整 SC 要知道采样时每个候选 token 的概率。普通 rollout 日志通常只留“实际抽中 token 的 logprob”,这不足以重建 E_q[s]。作者采用 top-k 日志,并用训练端分布补齐尾部。
令 H 为采样端的 top-k token 集合,T 是剩余词表。保留 H 上的真实 qᵥ,尾部沿用 p 的相对形状,再缩放到 q 的剩余概率质量:
最后一步用到了 Σ_all pᵥsᵥ=0。因而虽然近似分布覆盖整个词表,修正项只需显式处理 H。不能把 top-k 概率重新归一化到 1,否则真实的尾部质量就丢了;也不能改取训练端自己的 top-k,因为那不是日志中已知的那组 qᵥ。
“精确抵消”的范围要说清
完整 q 下的中心化精确取消条件漂移;top-k 实现中心化的是 q̂。真实 token 仍来自 q,因此残余项可以写成 E_q[s]−E_q̂[s]。如果尾部形状假设不准确,残余偏差仍可能存在。论文报告 k=32、128 在所测设置中接近全词表版本,这是经验结果,不是所有分布下的等价证明。
省下的是完整词表日志,传输成本仍需计算
按 1,024 条轨迹、每条 32,768 个生成 token 估算,保存 128 个 float32 logprob 需要 16 GiB;若再为每项保存一个 int32 token ID,总计约 32 GiB,尚未计入实际采样 token 和其他字段。这是解读者的容量估算,真实开销由有效 token 数、编码和流水线驻留量决定。
这也解释了“算 loss 只多一点工作”和“跨机器搬运没有成本”为什么不是同一个结论。论文的低耗时开销来自其自定义 JAX 采样器,不能直接当作任意 serving 框架的性能保证。
05如何与重要性采样组合
重要性采样(IS)用乘法调整样本权重,SC 用减法去掉期望 score,两者处理问题的角度不同。对固定前缀的动作分布,精确比率 pᵥ/qᵥ 满足 E_q[(p/q)s]=E_p[s]=0;但实际截断或屏蔽权重后,这个恒等式会被打破。
| 方法 | 逐 token 权重 w(r) | 这里要理解的取舍 |
|---|---|---|
| 精确 IS | r=p/q | 改变动作分布的权重;极端比率可能放大方差。 |
| TIS | min(r, 2) | 限制大权重,代价是引入截断偏差。 |
| MIS | r·1[0.5≤r≤5] | 屏蔽区间外样本,平均加权 score 未必为零。 |
| SC | 不靠比率重加权 | 减去平均 score,保留 q 下的协方差。 |
表中的阈值对应论文对照设置;不代表适用于所有任务的推荐参数。完整序列分布的精确 IS 还涉及整条轨迹比率,不能和常用 token 级近似混为一谈。
组合方法应当中心化已经加权的 score:
例如直接把已有 SC loss 乘一个抽样 token 的权重,减掉的就是 w_y·E_q[s],不是 E_q[ws];它通常不能保证常数奖励下期望更新为零。
在 top-k 尾部模型下,尾部比率恒为 1/ρ,于是可以继续把修正压缩成 head 上的和:
取 f(r)=1 就回到普通 SC;取 f(r)=r,得到 α=1 且 qᵥwᵥ=pᵥ,修正系数恰好为零。这是一个有用的实现检查:精确 IS 已经使平均加权 score 为零,无需再额外中心化。
06实验究竟支持什么
实验把不同校正规则放到共同的 REINFORCE + 组内奖励去均值目标上比较,每批只更新一次。它隔离的是校正规则,不是把 PPO、DAPO、GSPO 等各自完整训练方案重新跑一遍。因此,曲线优劣不能直接解释为整套算法的排名。
| 实验 | 设置 | 应当如何阅读 |
|---|---|---|
| 受控权重噪声 | Qwen3-0.6B,Countdown;采样权重加固定偏移 | 用来分离故障机制,和真实 serving 误差并不完全相同。 |
| 量化与陈旧度 | 0.6B;int8 采样,或每 64 步才刷新采样器 | 后者是周期刷新实验,不是普通“最大 staleness=64”的队列。 |
| 30B 扩展 | Qwen3-30B-A3B-Base,INTELLECT-2 math;加强采样端量化 | 观察强 TIM 下的训练稳定性;不是代码 Agent 基准。 |
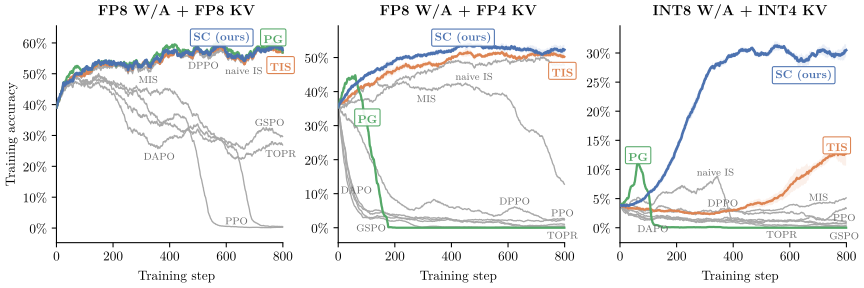
| 30B 量化条件 | 原文报告的结果 | 说明 |
|---|---|---|
| FP8 采样器 | 未经校正的 PG 也稳定,约 58% | 轻 TIM 时,不能预设任何校正都有明显收益。 |
| FP4 KV cache | SC 约 52%,TIS 约 51%;PG 崩溃,MIS 后期崩溃 | 这里 SC 与 TIS 的终点很接近,稳定性也要结合曲线看。 |
| INT8 W/A + INT4 KV | SC 约 30%,TIS 约 12%,其余方法结束时低于 5% | 差距来自刻意加强的量化压力;这是训练准确率。 |
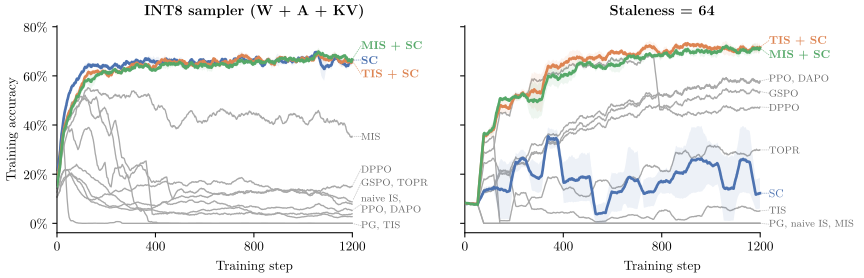
读曲线前先核对四个条件
- 压力是刻意放大的。作者在有限计算预算内加强 TIM,让方法在几百步内出现明显分离;这不是普通生产配置的收益预测。
- 长度较短。0.6B 主实验最长 512 token,30B 为 1,024;与动辄数万 token、多轮工具调用的 Agent 仍有距离。
- 指标不统一。图 2、3 用留出评测准确率;图 1、4、5 用采样轨迹的训练准确率,且做了平滑。
- 重复次数不均。小模型主要实验每条曲线 3 个种子;30B 各方法与条件为 1–5 个,阴影为 ±1 标准误。30B 的 k=32 与全词表消融为单种子。
07接入训练链路需要什么
以下是由公式推导出的工程检查,不是论文已完成的 Lego-RL / VeRL 集成。关键变化首先出现在数据链路,而不仅是多写一项 loss。
一个最小的普通 SC loss
下面是依据公式写的 PyTorch 教学实现,输入已经是 float32 log_softmax 的结果;没有包含词表并行、padding、分块或训练框架接口。advantage 应与 token 维度一致或可广播。
def sc_token_loss(logp, head_ids, q_head_logp, token_ids, advantage):
    # logp: [..., V]; head_ids / q_head_logp: [..., k]
    logp_h = logp.gather(-1, head_ids)
    logp_y = logp.gather(-1, token_ids[..., None]).squeeze(-1)
    p_h = logp_h.exp()
    q_h = q_head_logp.detach().exp()
    p_tail = (1 - p_h.sum(-1)).clamp_min(1e-6)
    q_tail = (1 - q_h.sum(-1)).clamp_min(1e-6)
    rho = q_tail / p_tail
    coeff = (q_h - rho[..., None] * p_h).detach()
    correction = (coeff * logp_h).sum(-1)
    return -advantage.detach() * (logp_y - correction)
detach() 是推导的一部分。虽然系数里出现 p 和 ρ,它们在这次更新中要作为固定权重;如果继续对系数求导,得到的就不是目标的中心化 score。尾部 floor 避免除零,却也改变了极端分布下的精确恒等式,需要监控触发频率。
容易漏掉的四个接口问题
- “返回的 logprob”代表哪个分布?温度、top-p / top-k 截断或其他 logits 处理会改变真实采样分布。必须核对接口返回的是变换前还是变换后的概率,不能仅靠字段名认定它就是 q。
- 多轮与 partial rollout 如何对齐?同一轨迹不同片段可能来自不同权重版本。top-k 日志必须对应当时的前缀,不能用更新后的采样器重算再假装是行为分布。
- 哪些 token 进入 loss?prompt、工具返回文本与 padding 通常不属于策略生成动作。SC 应沿用正确的 response mask;分组优势与长度归约也要保持一致。
- 训练内核是否拿得到这些概率?若现有 fused loss 只返回采样 token 的 logprob,就需要扩展 head 的读取路径;不能为了演示直接常驻完整 B×T×V 张量而忽略显存。
用小词表枚举检查:常数奖励下期望更新是否为零、p=q 时修正是否消失、加常数奖励是否保持 SC 不变、未截断 IS 的额外修正是否为零。然后在同一批 rollout 上比较全词表与 top-k 梯度,最后记录端到端吞吐、尾部质量、校正梯度规模与任务成功率。
数据字段和基础实现可对照作者仓库;上述系统接入讨论与代码为解读者整理,未声称已在本站关联训练项目中实施。
08局限与常见误读
| 容易得出的结论 | 更准确的判断 |
|---|---|
| 去均值就是减 reward baseline | 这里减的是 score 的期望。精确前缀 value baseline 在期望上能产生相同协方差,但实现与估计误差不同。 |
| SC 能替代全部 IS | SC 没有把 q 变成 p。模型跨同步移动较大时,论文的陈旧度实验更支持组合校正。 |
| 用 top-k 就精确无偏 | 尾部使用 q̂≈q 的假设;低概率尾部质量小,也不自动保证参数梯度误差小。 |
| 梯度期望正确就不可能崩 | 优化器、奖励、方差、数值问题和数据选择偏差仍然存在;SC 也不是一般的方差下降保证。 |
| 30B 的结果已证明长程 Agent 受益 | 目前展示的是数学与 Countdown 设置,需要单独验证长上下文、多轮工具、MoE 路由和实际异步调度。 |
| 修正 loss 后可以放任 serving 错误 | 概率校正无法恢复错误 tokenization、丢失上下文或错误环境执行;基础数据和实现一致性仍需保证。 |
对异步 Agentic RL,值得带走的是一个可定位的诊断问题:当前更新里,有多少方向来自任务成败,有多少只是采样分布与训练分布的差异乘上平均优势?SC 为后者提供了一个明确的局部修正,但是否值得上线,需要把收益与日志、传输、训练内核成本一起测量。
09与站内笔记的连接
两者都面对采样与训练不同步的问题。读 SAO 时关注版本差异与重要性校正;读 SC 时再问:截断后的加权 score 是否仍有非零均值?不要未经推导就把两套 loss 相乘。
完成顺序、样本准入和同步节奏决定哪些轨迹进入 batch;SC 处理给定前缀下的 score 均值。这些处于不同层次,loss 校正不会自动消除调度造成的样本选择偏差。
精确 value baseline 与 score centering 的期望关系,有助于理解 critic 的一个作用;但 reward 设计、时序信用分配与 critic 训练稳定性仍是独立问题。
| 想核对什么 | 原文位置 |
|---|---|
| 在线与离线训练为什么不同 | §3,图 2 |
| 漂移分解、组内中心化与 baseline | §4 |
| top-k、IS 组合与标量 loss | 附录 A |
| 量化、陈旧样本与 30B 结果 | §5,图 1 / 3 / 4 |
| 指标、长度、随机种子与计算预算 | 附录 B |