Fully Async Policy · 技术分享
Harbor × VeRL 全异步 RL 训练架构详解
从启动脚本到权重同步:一条样本如何走过 Rollouter、Agent Loop、Harbor 沙箱、轨迹 Proxy、MessageQueue,再进入 Trainer。
源文档:Verl+harbor全异步RL分享.md
主线示例:fully_async_2nodes.sh(1 节点 8 GPU Rollouter + 1 节点 8 GPU Trainer)
怎么读这篇
第 1 节讲为什么拆成两组 GPU以及四个旋钮;第 2 节是并发漏斗,读完就能回答「64 个并发卡在哪」;第 3–5 节是 Harbor 适配与 Token-in-Token-out;第 6–7 节是训练步与 Partial Rollout。附录是总图、文件索引和术语。
本文档以 fully_async_2nodes.sh 的启动流程为例,系统性地介绍从 VeRL 全异步训推框架、Agent Loop 抽象、Harbor SWE Agent Loop 适配、轨迹代理 Proxy、到训练与权重同步的完整链路。
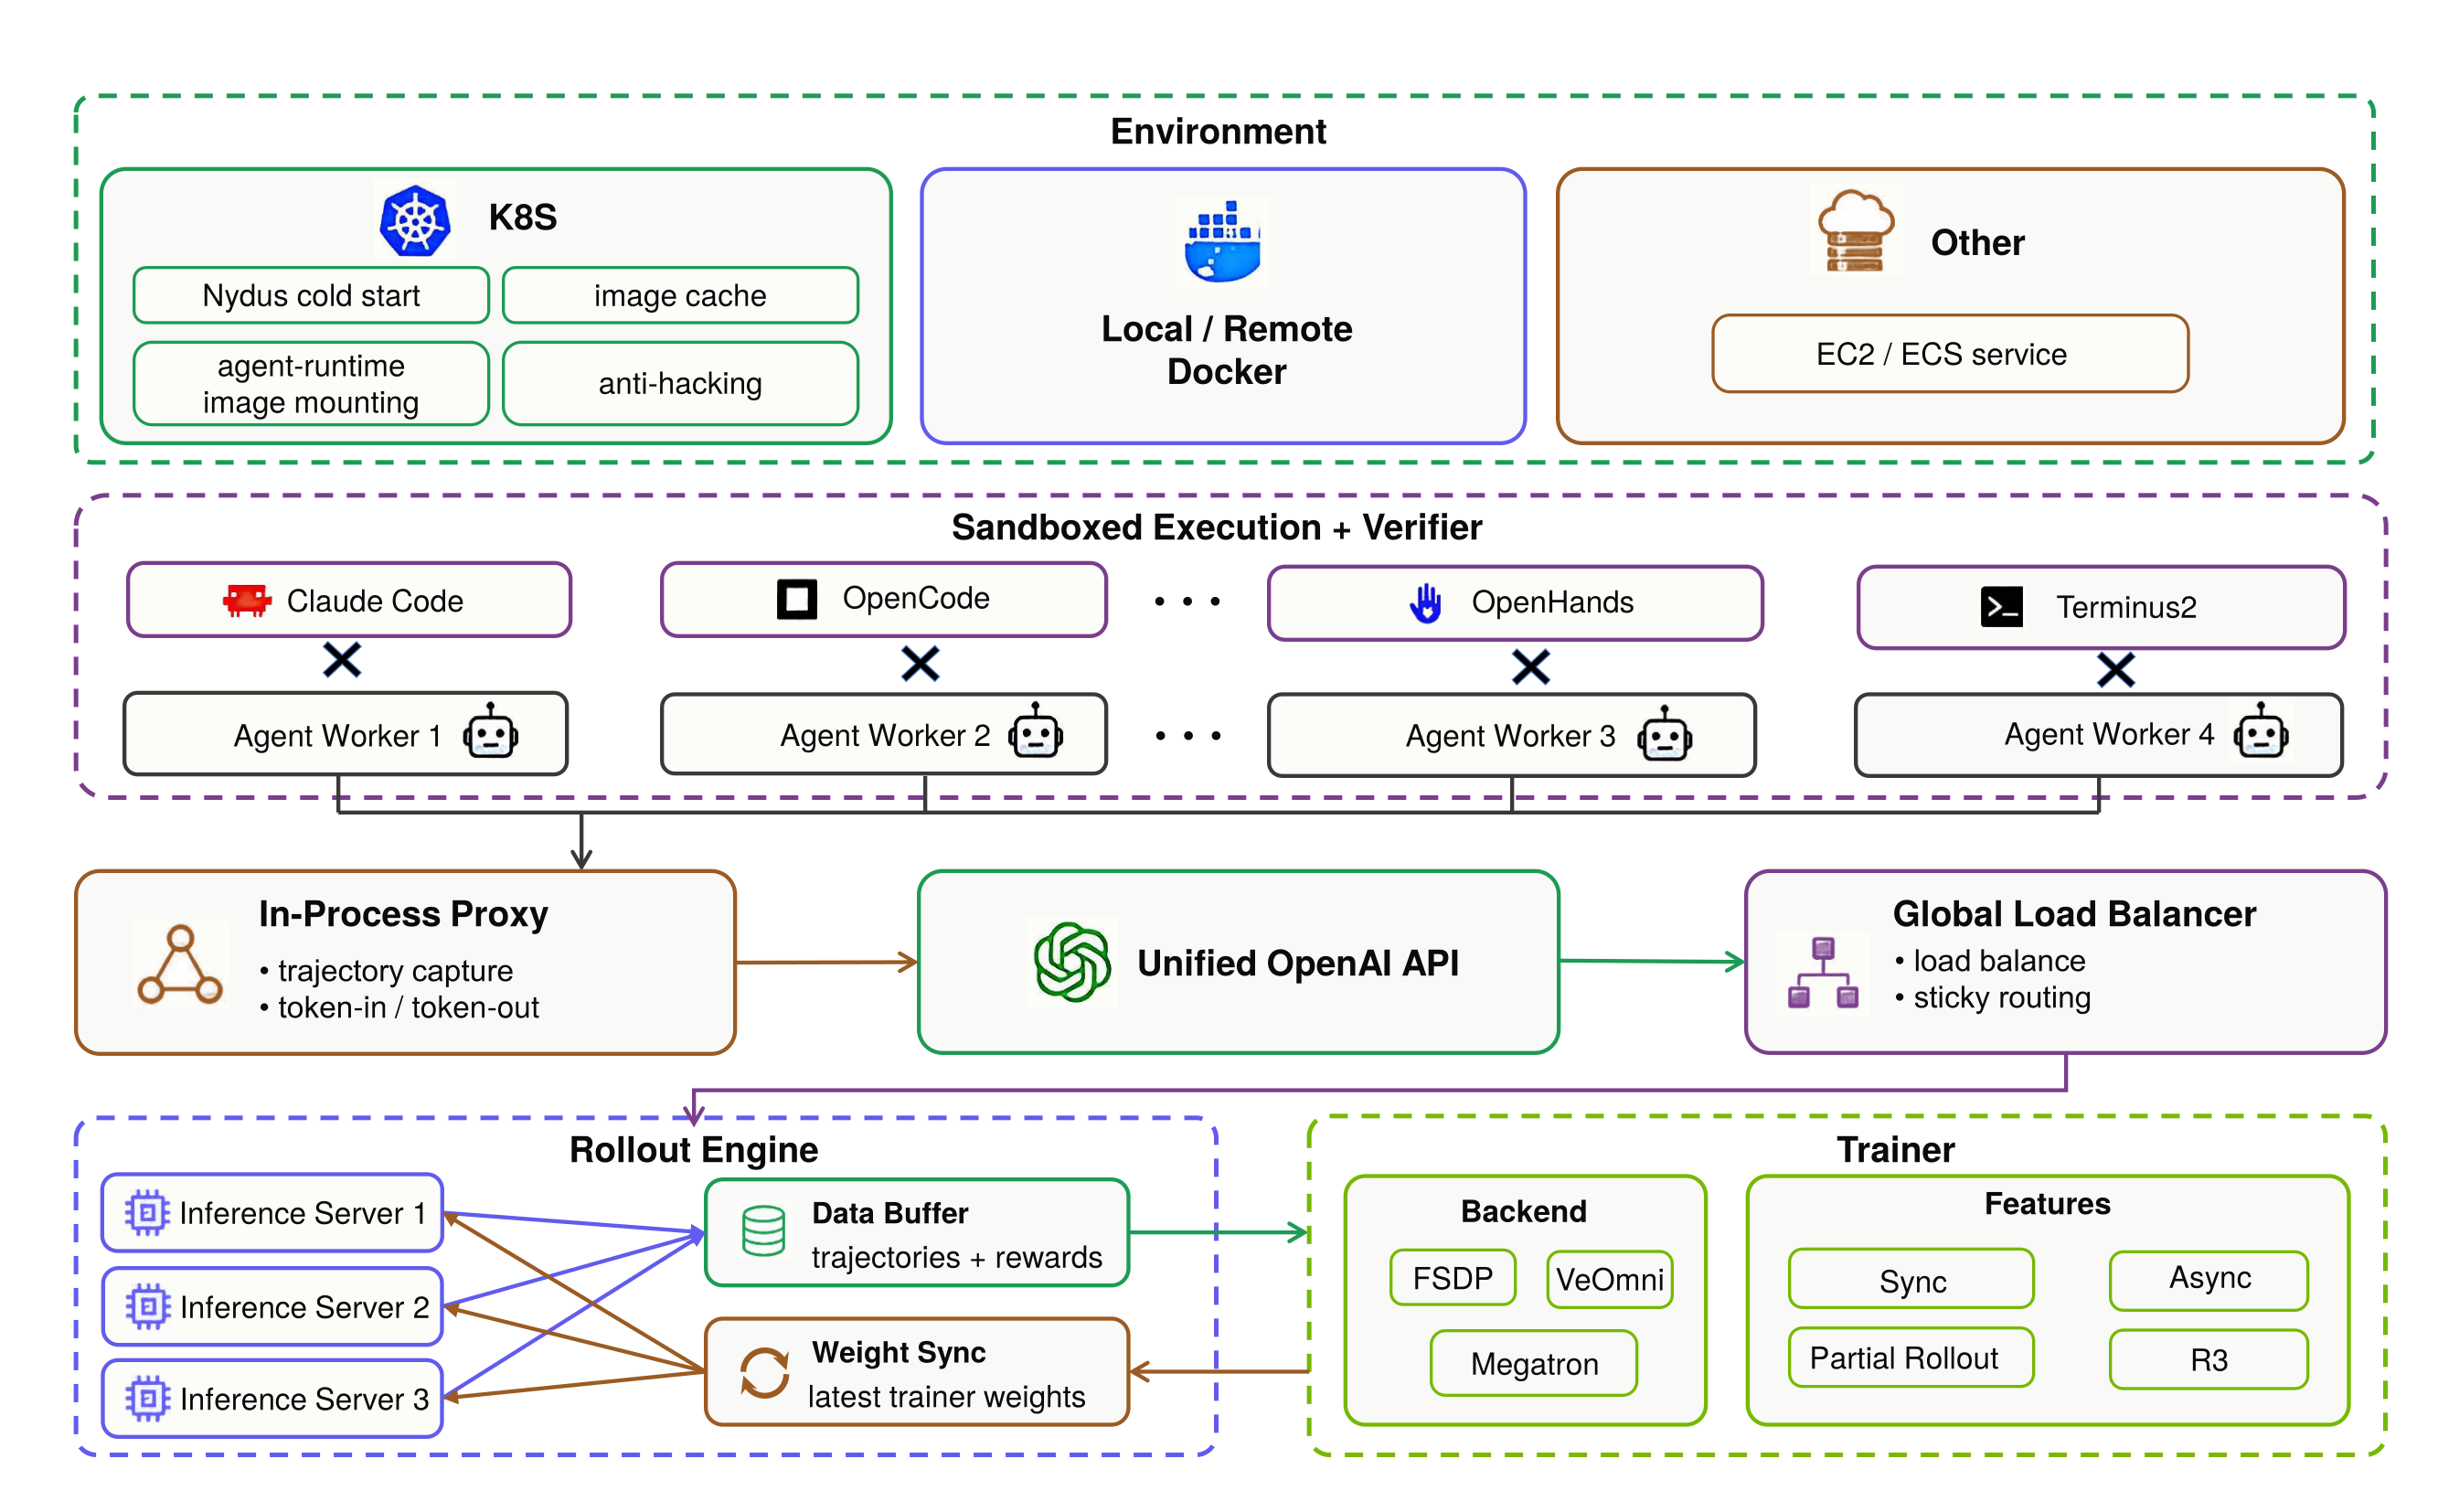 SWE-Lego RL Trainer 总览。点击可打开原图。来源:
SWE-Lego-RL-Trainer-framework-v2.pdf。
上 · Environment Harbor 沙箱:K8s / Docker / 云主机,对应第 4 节
中 · In-Process Proxy 进程内 aiohttp 假 vLLM,对应第 5 节
中 · Global Load Balancer 粘性路由 + 最少在途请求,对应第 2.5 节
下 · Rollout ↔ Trainer 样本缓冲、权重同步、Partial Rollout,对应第 1 / 6 / 7 节
1VeRL 全异步训推模式介绍
1.1 背景与动机
在传统的 Colocate(训推一体)架构中,Rollout 和 Training 共享同一组 GPU 资源。这种模式下存在严重的资源浪费问题:
- 长尾样本问题:多轮交互场景中,不同样本的 rollout 时间差异极大(code agent场景几分钟~几十分钟),导致大量 GPU 处于空闲等待状态。
- 训推串行:一次 rollout 完成后才能开始训练,训练完成后才能开始下一轮 rollout。
全异步训练(Fully Async Policy)通过资源隔离 + 并行生成与训练 + 流式样本传输彻底解耦了 Rollouter 和 Trainer,实现了 2.35x-2.67x 的训练吞吐提升。
1.2 核心架构四组件
01 · 生产者
Rollouter
独占一组 GPU,持续流式生成样本,以单样本为最小传输单元放入 MessageQueue。生成速度受 staleness 约束。
02 · 通道
MessageQueue
Ray Actor 异步队列,deque + asyncio.Condition 实现生产者-消费者,逐条传递样本。
03 · 消费者
Trainer
独占另一组 GPU,从队列取样本,攒够 require_batches × ppo_mini_batch_size 后执行一轮 PPO。
04 · 同步
ParameterSynchronizer
基于 NCCL,参考 checkpoint-engine,把 Trainer 新权重高效广播回 Rollouter。
┌─────────────────────────────────────────────────────────────────────┐
│                       Fully Async Policy                             │
│                                                                      │
│  ┌──────────┐    sample by sample   ┌──────────────┐                │
│  │ Rollouter │ ──────────────────> │ MessageQueue │                 │
│  │ (N GPUs) │                      │  (Ray Actor) │                 │
│  └──────────┘                       └──────┬───────┘                │
│       ▲                                    │ sample by sample        │
│       │ NCCL                               ▼                         │
│  ┌────┴──────────────┐              ┌──────────────┐                │
│  │ ParameterSynchronizer │<─────────│   Trainer    │                 │
│  │ (checkpoint-engine)  │          │  (M GPUs)    │                 │
│  └──────────────────────┘           └──────────────┘                │
└─────────────────────────────────────────────────────────────────────┘
- Rollouter:独占一组 GPU(如 8 卡),持续流式生成样本,以单样本为最小传输单元放入 MessageQueue。生成速度受 staleness(陈旧度)参数控制。
- MessageQueue:基于 Ray Actor 的异步消息队列,使用
deque + asyncio.Condition 实现生产者-消费者模式。
- Trainer:独占另一组 GPU(如 8 卡),从 MessageQueue 逐个取出样本,攒够
require_batches * ppo_mini_batch_size 个样本后执行一轮 PPO 训练。
- ParameterSynchronizer:基于 NCCL 通信原语,参考 checkpoint-engine,实现 Trainer 到 Rollouter 的高效参数同步。
1.3 收益来源
Colocate · 串行
|------ rollout 1(含长尾)------|-- train --|------ rollout 2 ------|
                  ↑
        绝大多数样本早已跑完,
        整批在等最慢的 1~2 条
Fully Async · 重叠
Rollouter  |--- 持续生成 ---|--- 持续生成 ---|--- 持续生成 ---|
Trainer             |---- train 1 ----|---- train 2 ----|
           ═══════> 两条时间线重叠,端到端大幅缩短
1.4 四种运行模式
Mode a
On Policy Pipeline
- sync step
- = 1
- staleness
- 0
- partial
- —
完全同步:每次训完立即同步参数。
Mode b
Stream Off Policy
- sync step
- > 1
- staleness
- 0
- partial
- —
流式同步:多步本地训练后才同步参数。
Mode c
Async Stream(stale)
- sync step
- ≥ 1
- staleness
- > 0
- partial
- False
允许陈旧样本;同步时等待活跃任务完成。
Mode d
Async Stream(partial)
- sync step
- ≥ 1
- staleness
- > 0
- partial
- True
允许陈旧样本;同步时中断并恢复进行中的 rollout。
| 模式 |
trigger_parameter_sync_step |
staleness_threshold |
partial_rollout |
特点 |
| a. On Policy Pipeline |
=1 |
0 |
- |
完全同步,每次训完立即同步参数 |
| b. Stream Off Policy Pipeline |
>1 |
0 |
- |
流式同步,多步训练后才同步参数 |
| c. Async Stream (stale) |
>=1 |
>0 |
False |
允许陈旧样本,同步时等待活跃任务完成 |
| d. Async Stream (partial) |
>=1 |
>0 |
True |
允许陈旧样本,同步时中断并恢复进行中的 rollout |
 四种运行模式的官方对比图。若内网图无法加载,以上方四张卡片和表格为准。
1.5 关键参数说明
async_training.trigger_parameter_sync_step
Trainer 执行多少次本地更新后,才与 Rollouter 做一次参数同步。一次本地更新 = 取到 require_batches × ppo_mini_batch_size 个样本。
两次同步之间 Trainer 处理的样本数 =
trigger_parameter_sync_step × require_batches × ppo_mini_batch_size
与 Colocate 公平比速度时,应设为 data.train_batch_size / (require_batches × ppo_mini_batch_size)。
async_training.staleness_threshold
允许使用的过期样本最大比例。num_staleness_sample 是上一窗口多生成、带进本窗口的过期样本数。Rollouter 慢时 Trainer 会更早触发同步,实际产不出满额 rollout_num。速度足够快且阈值设为 1,大致等价于 one-step-off。为避免过期样本伤精度,建议 小于 1。
阈值 = 0(同步):rollout_num = trigger × require_batches × ppo_mini_batch_size
阈值 > 0(异步):rollout_num = (1 + threshold) × trigger × require_batches × ppo_mini_batch_size − num_staleness_sample
async_training.partial_rollout
仅在 staleness_threshold > 0 时真正生效。为 True 时,权重同步会中断进行中的生成,同步后再从中断点续写。
async_training.require_batches
流式训练里通常设为 1:攒够一个 ppo_mini_batch_size 就训。实测一次分发太少会因数据顺序导致训练不稳、响应变长,所以用这个旋钮控制每次参训样本量。
actor_rollout_ref.actor.use_rollout_log_probs=True
PPO / GRPO / DAPO 的重要性采样要求 old_log_prob 与 rollout 当时的参数和 token 对齐。全异步默认由 Rollout 侧计算,而不是 Trainer 重算。
algorithm.rollout_correction.bypass_mode
默认 True:直接用 rollout log prob。训练后期指标或响应长度不稳时,可关掉它,改用训练引擎重算 log_prob,并启用 Rollout Importance Sampling。在 mode d + Partial Rollout 下,这近似 AReaL 的 Decoupled PPO。
1.6 快速启动示例
以 fully_async_2nodes.sh 为例,启动命令的核心是:
python -m verl.experimental.fully_async_policy.fully_async_main \
    --config-name='harbor_verl_fully_async_fsdp.yaml' \
    --config-path="$REPO_ROOT/src/verl_patch/config" \
    actor_rollout_ref.actor.ppo_mini_batch_size=64 \
    actor_rollout_ref.rollout.n=8 \
    async_training.staleness_threshold=1.0 \
    async_training.trigger_parameter_sync_step=1 \
    async_training.partial_rollout=True \
    async_training.require_batches=1 \
    rollout.nnodes=1 rollout.n_gpus_per_node=8 \
    trainer.nnodes=1 trainer.n_gpus_per_node=8 \
    # ... 其他训练超参数
这条命令启动了两个 Ray Actor——FullyAsyncTrainer(1 节点 8 GPU)和 FullyAsyncRollouter(1 节点 8 GPU),通过 MessageQueue 进行异步通信。
2VeRL Agent Loop 抽象与并发控制
2.1 Agent Loop 类层次结构
AgentLoopBase  (抽象基类)
├── SingleTurnAgentLoop   (单轮 agent,常规的单轮reasoning任务比如AIME,MATH500都用这个)
├── DiffusionSingleTurnAgentLoop  (扩散模型 agent)
├── ToolAgentLoop          (多轮工具调用 agent)
│   └── (AsyncPartialToolAgentLoop 能力通过 FullyAsyncLLMServerManager 注入)
└── BuiltinSWEAgentLoop    (适配harbor的 SWE-bench agent,直接继承 AgentLoopBase)
2.2 AgentLoopBase 核心抽象
agent_loop.py 中定义了核心数据结构和基础类:
# AgentLoopOutput 是单条轨迹的完整输出
class AgentLoopOutput:
    prompt_ids: list[int]         # prompt 的 token id 序列
    response_ids: list[int]       # response 的 token id 序列
    response_mask: list[int]      # 1=LLM 生成的 token, 0=tool/observation token
    response_logprobs: list[float] # 每个 response token 的 log 概率
    routed_experts: Any           # MoE 路由专家选择
    reward_score: float           # 奖励分数
    num_turns: int                # 对话轮次数
    metrics: dict                 # 性能指标
    extra_fields: dict            # 额外元数据
AgentLoopBase 的核心方法:
apply_chat_template(messages, tools, ...):将消息列表应用 chat template 得到 token idsrun(sampling_params, **kwargs) -> AgentLoopOutput:抽象方法,子类必须实现,运行一条完整轨迹
ToolAgentLoop 实现了标准的多轮工具调用循环:
                    ┌─────────┐
                    │ PENDING │  (初始状态:应用 chat template 得到 prompt_ids)
                    └────┬────┘
                         ▼
    ┌──────────────────────────────────────┐
    │              GENERATING              │ (调用 server_manager.generate())
    │  - 累积 response tokens (mask=1)     │
    │  - 提取 tool calls                   │
    │  - 检查终止条件                       │
    └───────┬──────────────┬───────────────┘
            │              │
    无 tool call      有 tool call
            │              │
            ▼              ▼
      ┌──────────┐  ┌──────────────────┐
      │TERMINATED│  │ PROCESSING_TOOLS │  (并行执行 tool calls, mask=0)
      └──────────┘  └────────┬─────────┘
                              │
                              ▼
                    回到 GENERATING (下一轮)
状态由 AgentData 对象承载,贯穿整个状态机,包含 messages、token ids、masks、logprobs 等全部轨迹状态。
2.4 并发控制全链路分析
全异步模式下,从 Rollouter 发起一个样本到最终在 Harbor 沙箱中完成执行,需要经过多层并发限制。下面以 fully_async_2nodes.sh 的配置为例(n_gpus_rollout=8, gen_tp=4, num_workers=128),逐层分析全链路的并发瓶颈。
2.4.1 配置回顾与关键数值计算
# 来自 fully_async_rollouter.py set_max_required_samples()

# 1. 最大陈旧样本数:一次参数同步窗口内,Rollouter 最多生成的样本总量
max_required_samples = required_samples * (staleness_threshold + 1) * trigger_parameter_sync_step
                    = (64 * 1) * (1.0 + 1) * 1
                    = 128

# 2. vLLM Server Replica 数量
num_replicas = n_gpus_rollout / tensor_model_parallel_size
             = 8 / 4 = 2   # 每个 replica 占用 4 张 GPU

# 3. 最大并发样本数
max_concurrent_samples = min(len(server_handles) * 32, max_required_samples)
                       = min(2 * 32, 128)
                       = min(64, 128) = 64

# 4. 最大队列容量
max_queue_size = max_required_samples = 128
2.4.2 第一层:pending_queue(数据加载 → 任务提交的缓冲区)
位置:FullyAsyncRollouter 内的 asyncio.Queue(maxsize=128)
[_feed_samples()]                          [_processor_worker()]
从 dataloader 逐条读取 batch_dict         从 pending_queue 取出样本
→ 包装为 RolloutSample                    → 创建 asyncio.Task 提交处理
→ await pending_queue.put(sample)         → 加入 active_tasks 集合

并发限制:Queue 有界(maxsize=128),feed 协程在 Queue 满时自动阻塞
位置:fully_async_rollouter.py:427-458 (_feed_samples)
      fully_async_rollouter.py:461-544 (_processor_worker)
作用:防止 dataloader 无限读取数据撑爆内存。feed 协程与 processor 协程以"生产者-消费者"模式解耦。
实际并发效果:Queue 中的样本尚未开始被处理,它们只是等待处理的数据缓冲。
2.4.3 第二层:active_tasks + max_concurrent_samples(任务提交的硬限制)
位置:FullyAsyncRollouter._processor_worker() 中的提交循环
# fully_async_rollouter.py:527-534
# 在提交新任务前,检查当前活跃任务数是否超限
while len(self.active_tasks) >= self.max_concurrent_samples:
    done_tasks, self.active_tasks = await asyncio.wait(
        self.active_tasks, return_when=asyncio.FIRST_COMPLETED
    )
    for task in done_tasks:
        await task

# 未超限时,创建一个新 asyncio.Task
task = safe_create_task(
    self._process_single_sample_streaming(rollout_sample),
    name=rollout_sample.sample_id,
    task_set=self.active_tasks,
)
作用:这是 Rollouter 侧对"同时在途样本数"的唯一硬限制(max_concurrent_samples = 64)。当 64 个样本都处于处理中(从提交给 async_rollout_manager 到结果写入 MessageQueue 之间)时,processor_worker 会阻塞直到至少一个任务完成。
2.4.4 第三层:AgentLoopWorker 池(Worker 级别的串行化)
位置:FullyAsyncAgentLoopManager.generate_sequences_single() 中的 asyncio.Queue Worker 池
# fully_async_policy/agent_loop/agent_loop.py:206-230
async def generate_sequences_single(self, prompts: DataProto) -> DataProto:
    queue = await self._init_worker_queue()  # 预填充 128 个 Worker
    single_samples = list(prompts.chunk(len(prompts)))

    async def process_task(sample: DataProto) -> DataProto:
        worker = await queue.get()     # 从池中获取一个空闲 Worker
        try:
            result = await worker.generate_sequences.remote(sample)
            # ↑ 在 Worker 内部: asyncio.gather(*tasks)
            # tasks 来自 batch 中的每条样本(这里每 batch 就是一条样本)
            return result
        finally:
            await queue.put(worker)   # 归还 Worker 到池中

    outputs = await asyncio.gather(*[process_task(sample) for sample in single_samples])
作用:num_workers = 128 个 FullyAsyncAgentLoopWorker(每个是一个 Ray Actor)构成 Worker 池。generate_sequences_single 被调用时,一个 batch(可能包含多条样本,在 n_resp_per_prompt=8 时就是 8 条)被拆分为单条样本,每条样本通过 queue.get() 获取一个空闲 Worker 来执行。
实际并发效果:最多有 128 个 AgentLoopWorker 同时在处理样本。但由于上游 max_concurrent_samples = 64,实际同时在途的样本不会超过 64 个,所以这一层在当前配置下不是瓶颈。
2.4.5 第四层:单个 AgentLoopWorker 内部的并发(batch 内样本并行)
位置:AgentLoopWorker.generate_sequences()
# agent_loop.py:601-611
tasks = []
for i in range(len(batch)):   # batch 中有多少条样本
    tasks.append(asyncio.create_task(
        self._run_agent_loop(sampling_params, trajectory_info[i], ...)
    ))
outputs = await asyncio.gather(*tasks)
作用:一个 AgentLoopWorker 收到一个 batch 后,对 batch 内的每条样本(每个 agent_name → BuiltinSWEAgentLoop.run())都创建一个 asyncio.Task 并 gather 并行执行。所以一个 Worker 可同时运行多条样本的 BuiltinSWEAgentLoop.run()。
2.4.6 第五层:Harbor 沙箱侧(K8s Pod / Docker 容器的资源上限)
Harbor 侧的并发没有额外的软件层限制——K8s Pod 的创建数量仅受 K8s 集群资源(CPU/内存配额)限制。这意味着:当 128 个样本同时进入 Harbor Trial.run() 时,会同时创建多达 128 个 K8s Pod。这通常需要 K8s 集群有足够的节点资源,否则 Pod 会排队等待调度。
2.4.7 第六层:vLLM Server(GPU 推理的物理上限)
每个 LLM 推理请求最终通过 FullyAsyncLLMServerManager.generate() → AsyncLLMServerManager.generate() 发送到 vLLM Server replica。
Rollout 侧 8 GPU, gen_tp=4 → 2 个 vLLM Server Replica
每个 Replica 是一个独立的 vLLM 实例,可处理多个并发请求

GlobalRequestLoadBalancer 通过 sticky session + least-inflight-requests
将请求分配到具体的 vLLM Server
实际限制:2 个 vLLM Server Replica 承载 64 个并发样本中的所有 LLM 推理请求。由于每个样本是多轮交互(LLM 推理 → 工具执行 → LLM 推理 → ...),并非所有请求同时到达 vLLM,实际的 vLLM 并发压力取决于各样本的节奏交错情况。
2.4.8 全链路并发总结
pending_queue · 128
数据缓冲,满则阻塞 dataloader
active_tasks · 64
Rollouter 唯一软件硬限制
AgentLoopWorker 池 · 128
当前配置下不是瓶颈
Harbor / K8s Pod · ≤64
受集群 CPU / 内存配额约束
vLLM · 2 replicas(dp2 tp4)
GPU 推理物理上限,通常是最紧的一层
Dataloader
  │ 逐条读取
  ▼
pending_queue (maxsize=128, asyncio.Queue)
  │ 取出提交
  ▼
active_tasks (max_concurrent=64, asyncio.Task 集合)
  │ 每个 task 调用:
  │   async_rollout_manager.generate_sequences_single()
  ▼
AgentLoopWorker 池 (num_workers=128, asyncio.Queue)
  │ 每个 Worker 处理 1 条样本
  │ 内部 asyncio.gather 并行执行 batch 内样本
  ▼
BuiltinSWEAgentLoop.run()
  │ 启动 Proxy → Harbor Trial.run()
  ▼
┌─────────────────────────────────────┐
│            Harbor 沙箱               │
│  K8s Pod / Docker Container          │
│  ├─ Agent 启动                       │
│  └─ Agent 循环:                     │
│      ├─ HTTP → Proxy → vLLM (2 replicas)│  ← GPU 推理的物理上限
│      └─ 工具执行 (bash/edit/git)     │
└─────────────────────────────────────┘
  │ 结果序列化,写入 MessageQueue
  ▼
MessageQueue (Ray Actor, deque)
  │
  ▼
FullyAsyncTrainer 消费
并发瓶颈排序(从紧到松):
| 位置 |
并发上限 |
限制类型 |
备注 |
| vLLM Server Replicas |
dp2tp4(GPU 物理资源) |
硬件 |
8 GPU / gen_tp=4,所有 LLM 推理的物理上限 |
| active_tasks |
64 |
软件硬限制 |
min(2*32, 128),Rollouter 侧的唯一并发硬限制 |
| pending_queue |
128 |
软件缓冲 |
缓冲 128 个待处理样本,超过则阻塞 feed |
| AgentLoopWorker 池 |
128 |
软件容量 |
当前低于 active_tasks × 8 的理论上限,因此不是瓶颈 |
| K8s 集群资源 |
取决于集群 |
基础设施 |
64 个 Pod 需要足够的 CPU/内存 |
2.5 GlobalRequestLoadBalancer:粘性会话与最少请求数负载均衡
GlobalRequestLoadBalancer 是一个全局共享的 Ray Actor,负责将 LLM 推理请求路由到具体的 vLLM Server Replica。所有 AgentLoopWorker 共享同一个 LoadBalancer 实例。
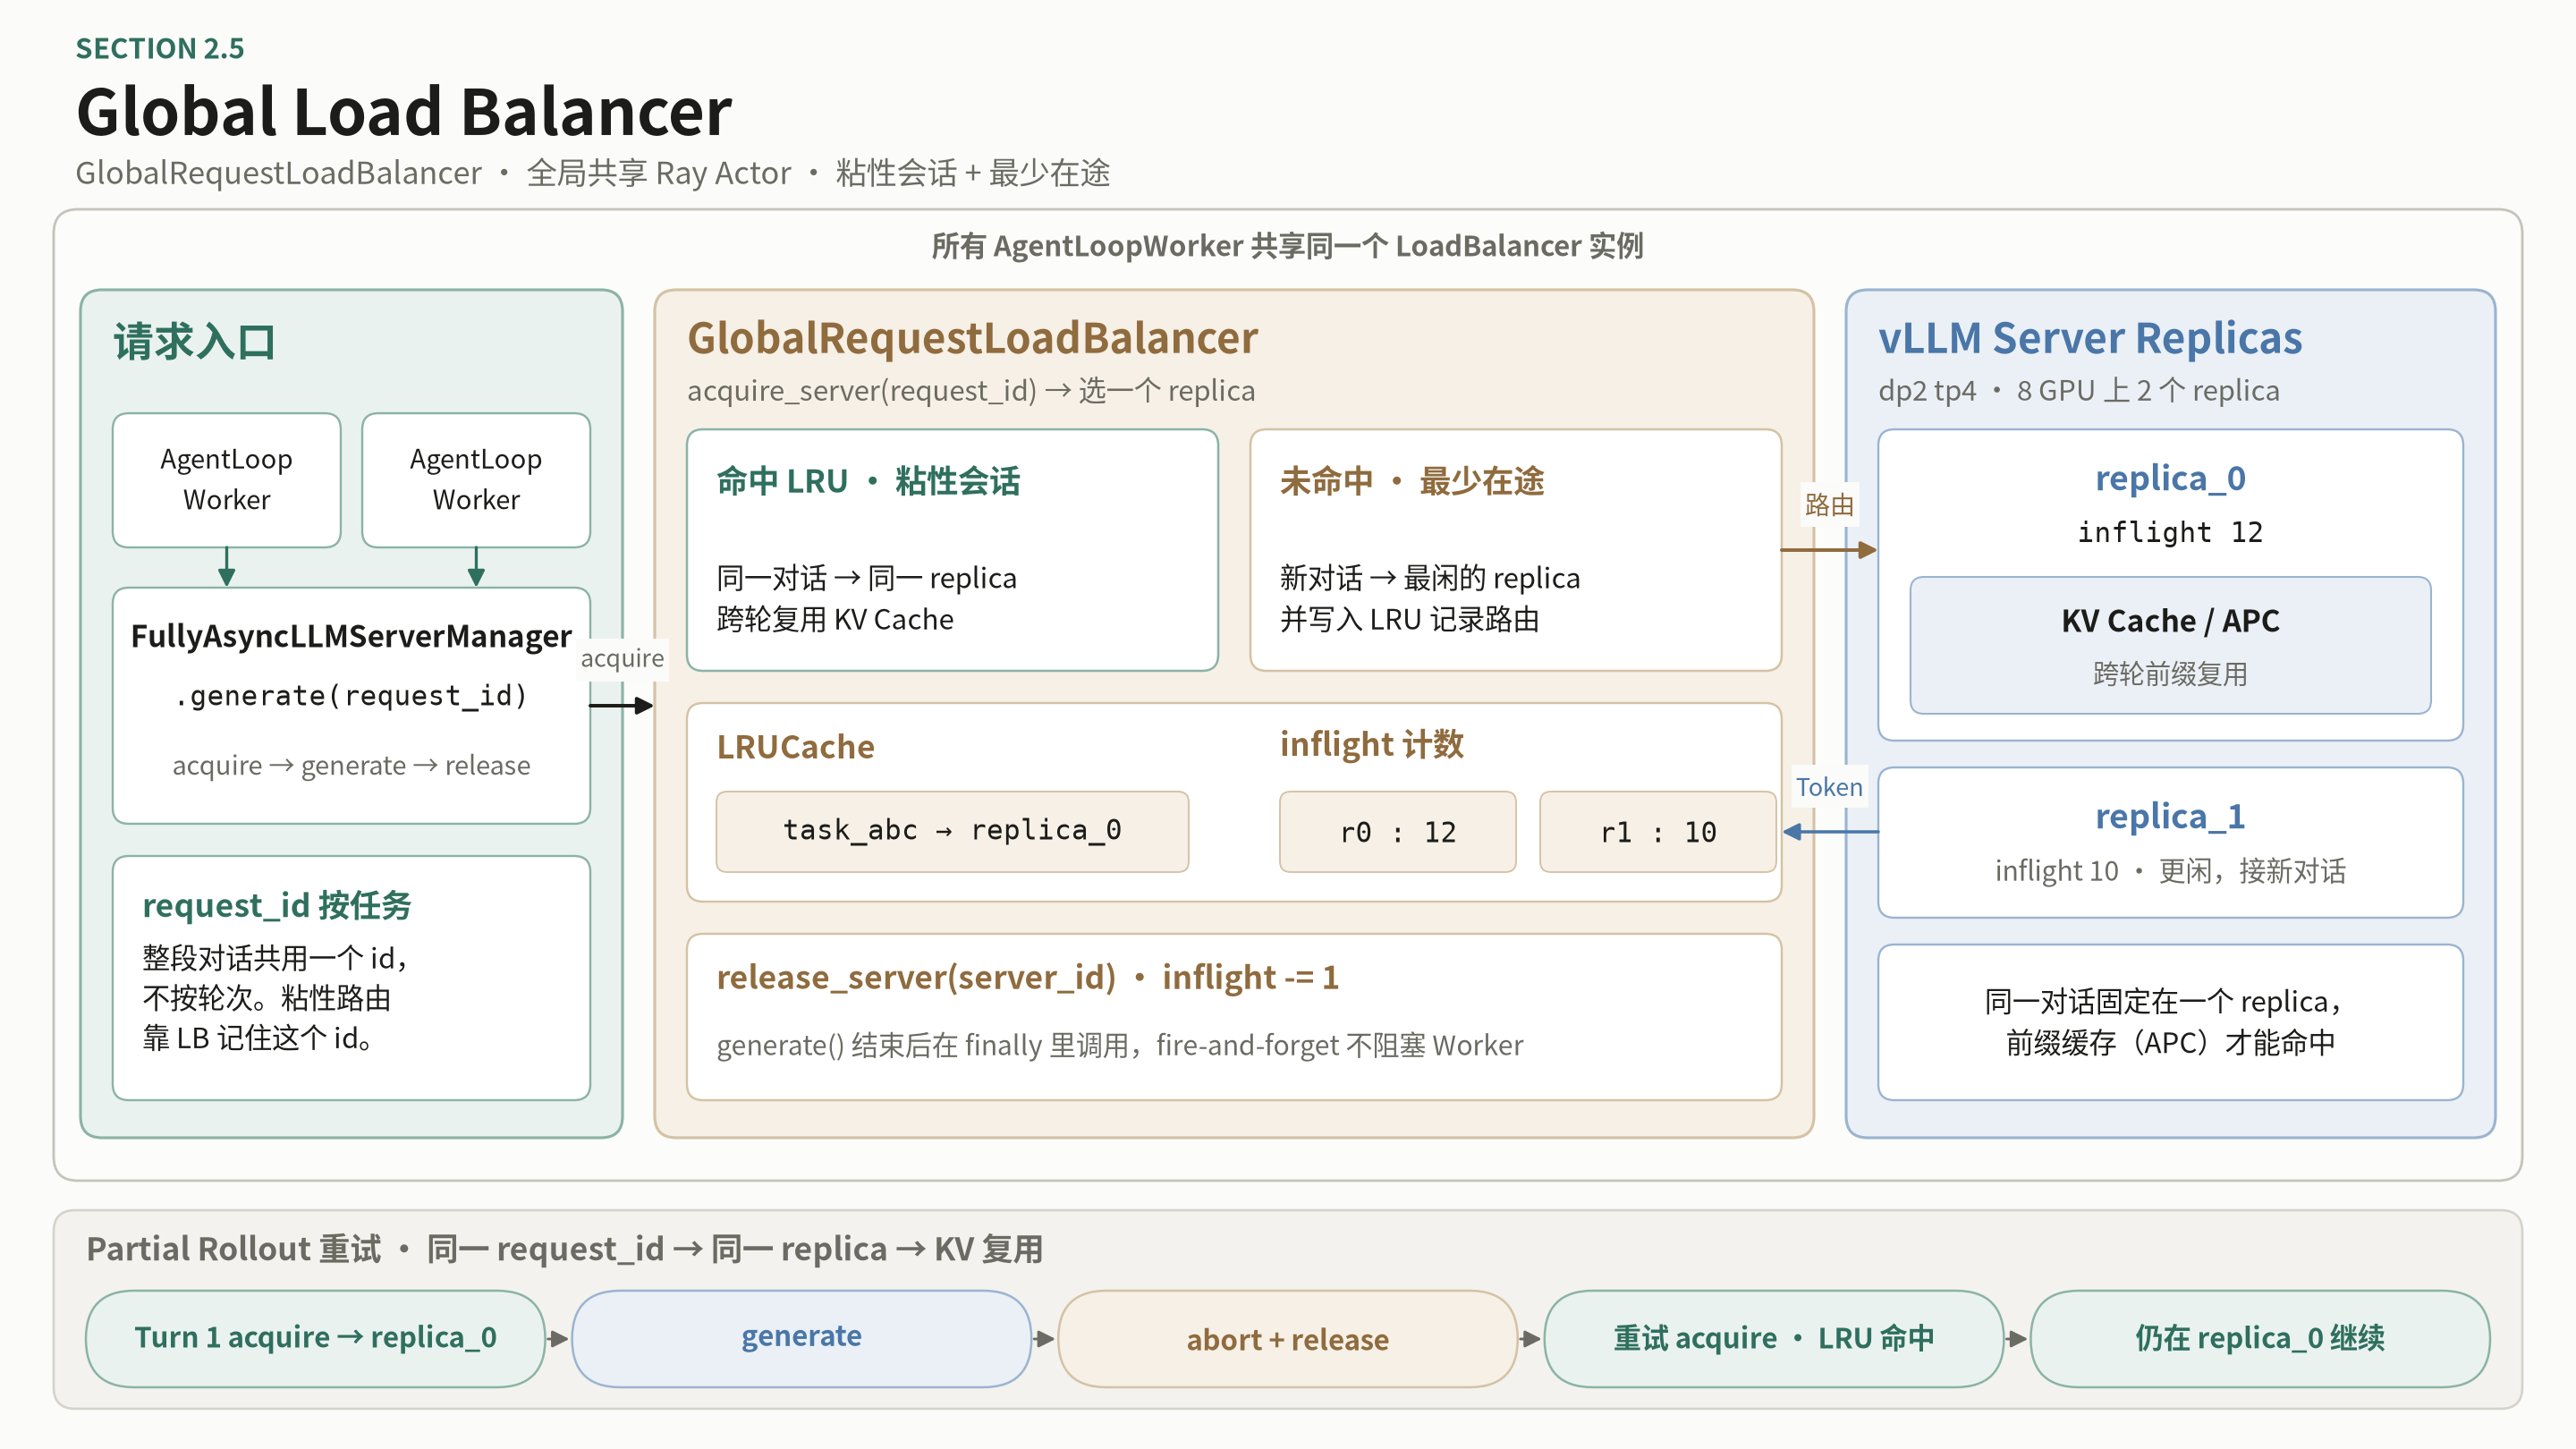 Global Load Balancer 架构。共享 Ray Actor,sticky session + least inflight;Partial Rollout 用同一 request_id 复用 KV Cache。点击可打开原图。
2.5.1 核心数据结构
# agent_loop.py:65-97
@ray.remote
class GlobalRequestLoadBalancer:
    def __init__(self, server_actor_ids: list[str], max_cache_size: int = 10000):
        self._inflight_requests: dict[str, int] = {sid: 0 for sid in server_actor_ids}
        self._request_id_to_server: LRUCache = LRUCache(maxsize=max_cache_size)
        # 例如: _inflight_requests = {
        #   "replica_0": 12,   # replica_0 上当前有 12 个在途请求
        #   "replica_1": 10,   # replica_1 上当前有 10 个在途请求
        # }
2.5.2 acquire_server:路由决策算法
def acquire_server(self, request_id: str) -> str:
    # 策略 1: 粘性会话(Sticky Session)
    # 同一 request_id 的路由记录在 LRU Cache 中,保证同一对话的所有 turn 发送到同一 replica
    if request_id in self._request_id_to_server:
        server_id = self._request_id_to_server[request_id]
        self._inflight_requests[server_id] += 1  # 在途请求数 +1
        return server_id

    # 策略 2: 最少在途请求数(Least Inflight Requests)
    # 新请求选择当前负载最轻的 replica
    server_id = min(self._inflight_requests, key=self._inflight_requests.get)
    self._request_id_to_server[request_id] = server_id
    self._inflight_requests[server_id] += 1
    return server_id

def release_server(self, server_id: str) -> None:
    # 请求完成后在 finally 块中调用,在途请求数 -1
    self._inflight_requests[server_id] -= 1
2.5.3 在请求生命周期中的位置
在 AsyncLLMServerManager.generate() 中(被 FullyAsyncLLMServerManager.generate() 的每次内部迭代调用):
async def generate(self, request_id, *, prompt_ids, sampling_params, ...):
    # 1. 从 LoadBalancer 获取 server, 这里request_id是一个完整任务一个
    server_id, server = await self._acquire_server(request_id)
    #    → LoadBalancer.acquire_server(request_id)
    #      返回 (server_id, server_handle)

    try:
        # 2. 向选中的 vLLM Server 发送推理请求
        output = await server.generate.remote(
            request_id=uuid4().hex,  # 每次推理用新的 request_id,这个request_id是每轮对话不一样的
            prompt_ids=prompt_ids,
            sampling_params=sampling_params,
            ...
        )
        return output
    finally:
        # 3. 释放 server(fire-and-forget,减少延迟)
        self._release_server(server_id)
        #    → LoadBalancer.release_server(server_id)
        #      在途请求数 -1
2.5.4 设计目标
- 粘性会话(Sticky Session):同一对话的多个 turn 被分配到同一个 vLLM Server Replica,使得 vLLM 的 Automatic Prefix Caching(APC)可以复用前面 turn 的 KV Cache,显著减少 prefill 开销。
- 最少请求均衡(Least Inflight):新对话(首次请求)被分配到当前负载最轻的 replica,避免某个 replica 被过度分配而另一个闲置。
2.5.5 与 FullyAsyncLLMServerManager 的交互
FullyAsyncLLMServerManager.generate(request_id="task_abc")
  │
  ├── 第 1 次调用 super().generate(request_id="task_abc")
  │     → LoadBalancer.acquire_server("task_abc") → 首次路由 → replica_0
  │     → vLLM 推理,中途被 abort → stop_reason="aborted"
  │     → LoadBalancer.release_server("replica_0")  (fire-and-forget)
  │
  ├── [partial_rollout=True, 自动重试]
  │
  └── 第 2 次调用 super().generate(request_id="task_abc")
        → LoadBalancer.acquire_server("task_abc") → LRU Cache 命中 → replica_0
        → 同一个 replica,继续生成
关键点:FullyAsyncLLMServerManager 的 partial rollout 重试用的是同一个 request_id,所以 LoadBalancer 会保证它被分配到同一个 vLLM Server Replica,从而可以复用已有的 KV Cache。
3Harbor SWE Agent Loop 适配
3.1 BuiltinSWEAgentLoop 概述
BuiltinSWEAgentLoop 继承自 AgentLoopBase,是与 VeRL 框架的集成桥梁。其核心设计思想是:将完整的 Harbor Trial 执行过程封装为 VeRL 的一次 run() 调用。
VeRL AgentLoopManager
  └── BuiltinSWEAgentLoop.run(sampling_params, **kwargs)
       ├── 从 kwargs 提取 task_path 和 extra_info
       ├── 获取/启动 _VLLMChatCompletionsProxy(单例)
       ├── 调用 _run_harbor_trial() → Harbor Trial.run()
       ├── 从 Proxy Session 提取轨迹 token_ids
       └── 构建并返回 AgentLoopOutput
| 特性 |
ToolAgentLoop |
BuiltinSWEAgentLoop |
| 谁控制 Agent 循环 |
VeRL(状态机驱动) |
Harbor(Trial.run 内部) |
| 工具执行位置 |
VeRL 进程内 |
Harbor 沙箱内(K8s Pod/Docker) |
| 模型推理调用方式 |
直接调用 server_manager.generate() |
通过 HTTP Proxy 间接触发 |
| 轨迹 token 来源 |
状态机自身累积 |
Proxy 会话捕获 |
| 支持 Partial Rollout |
通过 FullyAsyncLLMServerManager |
通过 Proxy → FullyAsyncLLMServerManager |
| 验证方式 |
VeRL RewardModel |
Harbor Verifier(运行测试套件) |
3.3 关键配置注入
BuiltinSWEAgentLoop 接收 harbor_cfg 字典,包含:
harbor_cfg = {
    "agent": {
        "name": "oh",                          # Agent 名称
        "import_path": "harbor_patch...:OpenHands",  # Agent 类导入路径
        "max_iterations": 100,                 # 最大迭代次数
        "tool_parser": "hermes",               # Tool Parser 类型
        "trials_dir": "./harbor_trials",       # 轨迹输出目录
        "max_retries": 2,                      # 最大重试次数
        "env": {                               # Agent 环境变量
            "LLM_BASE_URL": "由Proxy动态注入",
            "LLM_API_KEY": "...",
        }
    },
    "task": {"path": "/path/to/task"},
    "environment": {
        "import_path": "...:KubernetesEnvironment",
        "override_cpus": 1,
        "override_memory_mb": 8192,
    }
}
3.4 错误处理与重试策略
_run_harbor_trial() 中的重试逻辑:

for attempt in range(max_retries):
    ├── 创建新 session_id, 新 api_base, 新 trajectory_dir
    ├── 调用 Harbor Trial.run()
    ├── 根据异常类型决定行为:
    │   ├── AgentTimeoutError  → 不重试,取 reward 返回
    │   ├── ContextLengthExceededError → 不重试,reward=0
    │   ├── NonZeroAgentExitCodeError  → 不重试,取 reward 返回
    │   ├── 无 verifier_result  → 重试
    │   └── 其他异常           → 重试
    └── 成功 → break
4Harbor 内部 Rollout 执行过程
4.1 整体流程概览
一次完整的 Harbor Trial 执行包含四大阶段,对应四个 TimingInfo 对象:
┌──────────────────────────────────────────────────────────────────┐
│                    Harbor Trial.run()                             │
│                                                                   │
│  ┌─────────────────┐                                             │
│  │ 1. env_setup    │  K8s Pod 创建 / Docker 容器启动               │
│  │   环境搭建        │  执行任务 Dockerfile (RUN/WORKDIR/COPY)    │
│  └────────┬────────┘                                             │
│           ▼                                                       │
│  ┌─────────────────┐                                             │
│  │ 2. agent_setup  │  安装 Agent 依赖 / 配置环境变量               │
│  │   Agent 初始化   │  设置 LLM_BASE_URL 指向 Proxy              │
│  └────────┬────────┘                                             │
│           ▼                                                       │
│  ┌─────────────────────────────────────────────────────────────┐ │
│  │ 3. agent_execute (多轮 LLM 交互 + 工具执行循环)               │ │
│  │                                                              │ │
│  │   ┌──────────────────┐     ┌──────────────────┐             │ │
│  │   │  model_inference │────>│  tool_execute    │             │ │
│  │   │  HTTP POST 到    │<────│  在沙箱中执行      │             │ │
│  │   │  Proxy (/v1/chat │     │  bash/file/git等  │             │ │
│  │   │   /completions)  │     │                   │             │ │
│  │   └──────────────────┘     └──────────────────┘             │ │
│  │         重复直到 Agent 决定 stop 或达到限制                    │ │
│  └─────────────────────────────┬───────────────────────────────┘ │
│                                ▼                                  │
│  ┌─────────────────┐                                             │
│  │ 4. verify       │  运行测试套件 (pytest/unittest)              │
│  │   结果验证        │  计算 reward                               │
│  └─────────────────┘                                             │
└──────────────────────────────────────────────────────────────────┘
4.2 阶段详解
4.2.1 env_setup(环境搭建)
由 KubernetesEnvironment(或 RemoteDockerEnvironment)负责:
- 解析任务目录中的 Dockerfile
- 创建 K8s Pod(或 Docker 容器),应用资源配置(CPU/Memory/Volumes)
- 执行环境构建(Dockerfile 中的 RUN 命令)
- 支持 inline-build 模式:在 Pod 内直接执行 Dockerfile 指令
- 支持 Nydus 镜像加速和 hostPath 路径重写
4.2.2 agent_setup(Agent 初始化)
- 将 Agent 运行时挂载到环境(image volume 或 pip install)
- 设置环境变量(
LLM_BASE_URL, LLM_API_KEY 等),指向 Proxy 的地址
- 渲染 Agent 的 user prompt(Jinja2 模板)
4.2.3 agent_execute(Agent 执行循环)
这是核心的多轮交互阶段。Harbor Agent(如 OpenHands)在沙箱中运行:
┌─────────────┐     HTTP POST /v1/chat/completions    ┌──────────────┐
│             │ ──────────────────────────────────>  │              │
│   Harbor    │     {"messages": [...], "tools": ..}  │   Proxy      │
│   Agent     │                                       │  (aiottp)    │
│  (LiteLLM)  │ <────────────────────────────────── │              │
│             │     {"choices": [{...}], ...}        │              │
└──────┬──────┘                                       └──────┬───────┘
       │                                                      │
       │ 收到 assistant message                               │ server_manager
       │ (含 content 和 可选的 tool_calls)                     │ .generate()
       ▼                                                      │
  ┌──────────┐                                               │
  │ 执行工具  │  bash, edit, git, etc.                         │
  └────┬─────┘                                               │
       │ 工具结果作为新 user/tool message                       │
       │ 加入消息历史                                          │
       └──────────────────────────────────────────────────────┘
                    下一轮 HTTP 请求
4.2.4 verify(结果验证)
- 在沙箱中运行测试套件(通过 Harbor Verifier)
- 返回二值 reward(0.0 或 1.0)
4.3 时序数据收集
*collect × harbor_timings() 从 TrialResult 中提取各阶段耗时,上报到 VeRL 的 metrics 系统:
metrics = {
    "harbor_env_setup": 12.3,       # 环境搭建耗时 (秒)
    "harbor_agent_setup": 5.1,      # Agent 初始化耗时
    "harbor_agent_execute": 45.7,   # Agent 执行循环耗时
    "harbor_verifier": 30.2,        # 验证耗时
    "harbor_total": 93.3,           # 总耗时
}
5轨迹代理 Proxy 功能
5.1 整体架构
_VLLMChatCompletionsProxy 是一个进程内的 aiohttp HTTP Server,伪装成一个标准的 OpenAI 兼容 vLLM 端点,使得 Harbor Agent 无需任何修改即可通过 LiteLLM 与之通信。
aiohttp HTTP Server 是什么
aiohttp 是 Python 的异步 HTTP 库。HTTP Server 的意思是:在当前进程里用它真正监听一个端口、接收 HTTP 请求、返回 JSON——和 nginx / uvicorn 扮演的角色一样,只是服务嵌在 VeRL 的 AgentLoopWorker 进程内部,不另起进程。
Harbor 沙箱里的 Agent(LiteLLM / Claude Code)只会调「OpenAI 兼容的 HTTP 接口」,不会直接调 VeRL 的 Python 函数。所以 Worker 启动时用 aiohttp 绑在 0.0.0.0:{随机端口},对外宣称自己是 vLLM:POST /v1/chat/completions 进来后,Proxy 做 tokenize、记轨迹,再转给 server_manager.generate()。
之所以用 aiohttp 而不是 Flask,是因为它和 VeRL 共用同一条 asyncio 事件循环:几十条并发轨迹的 HTTP 请求可以同时挂起等待推理,不会把事件循环堵死。
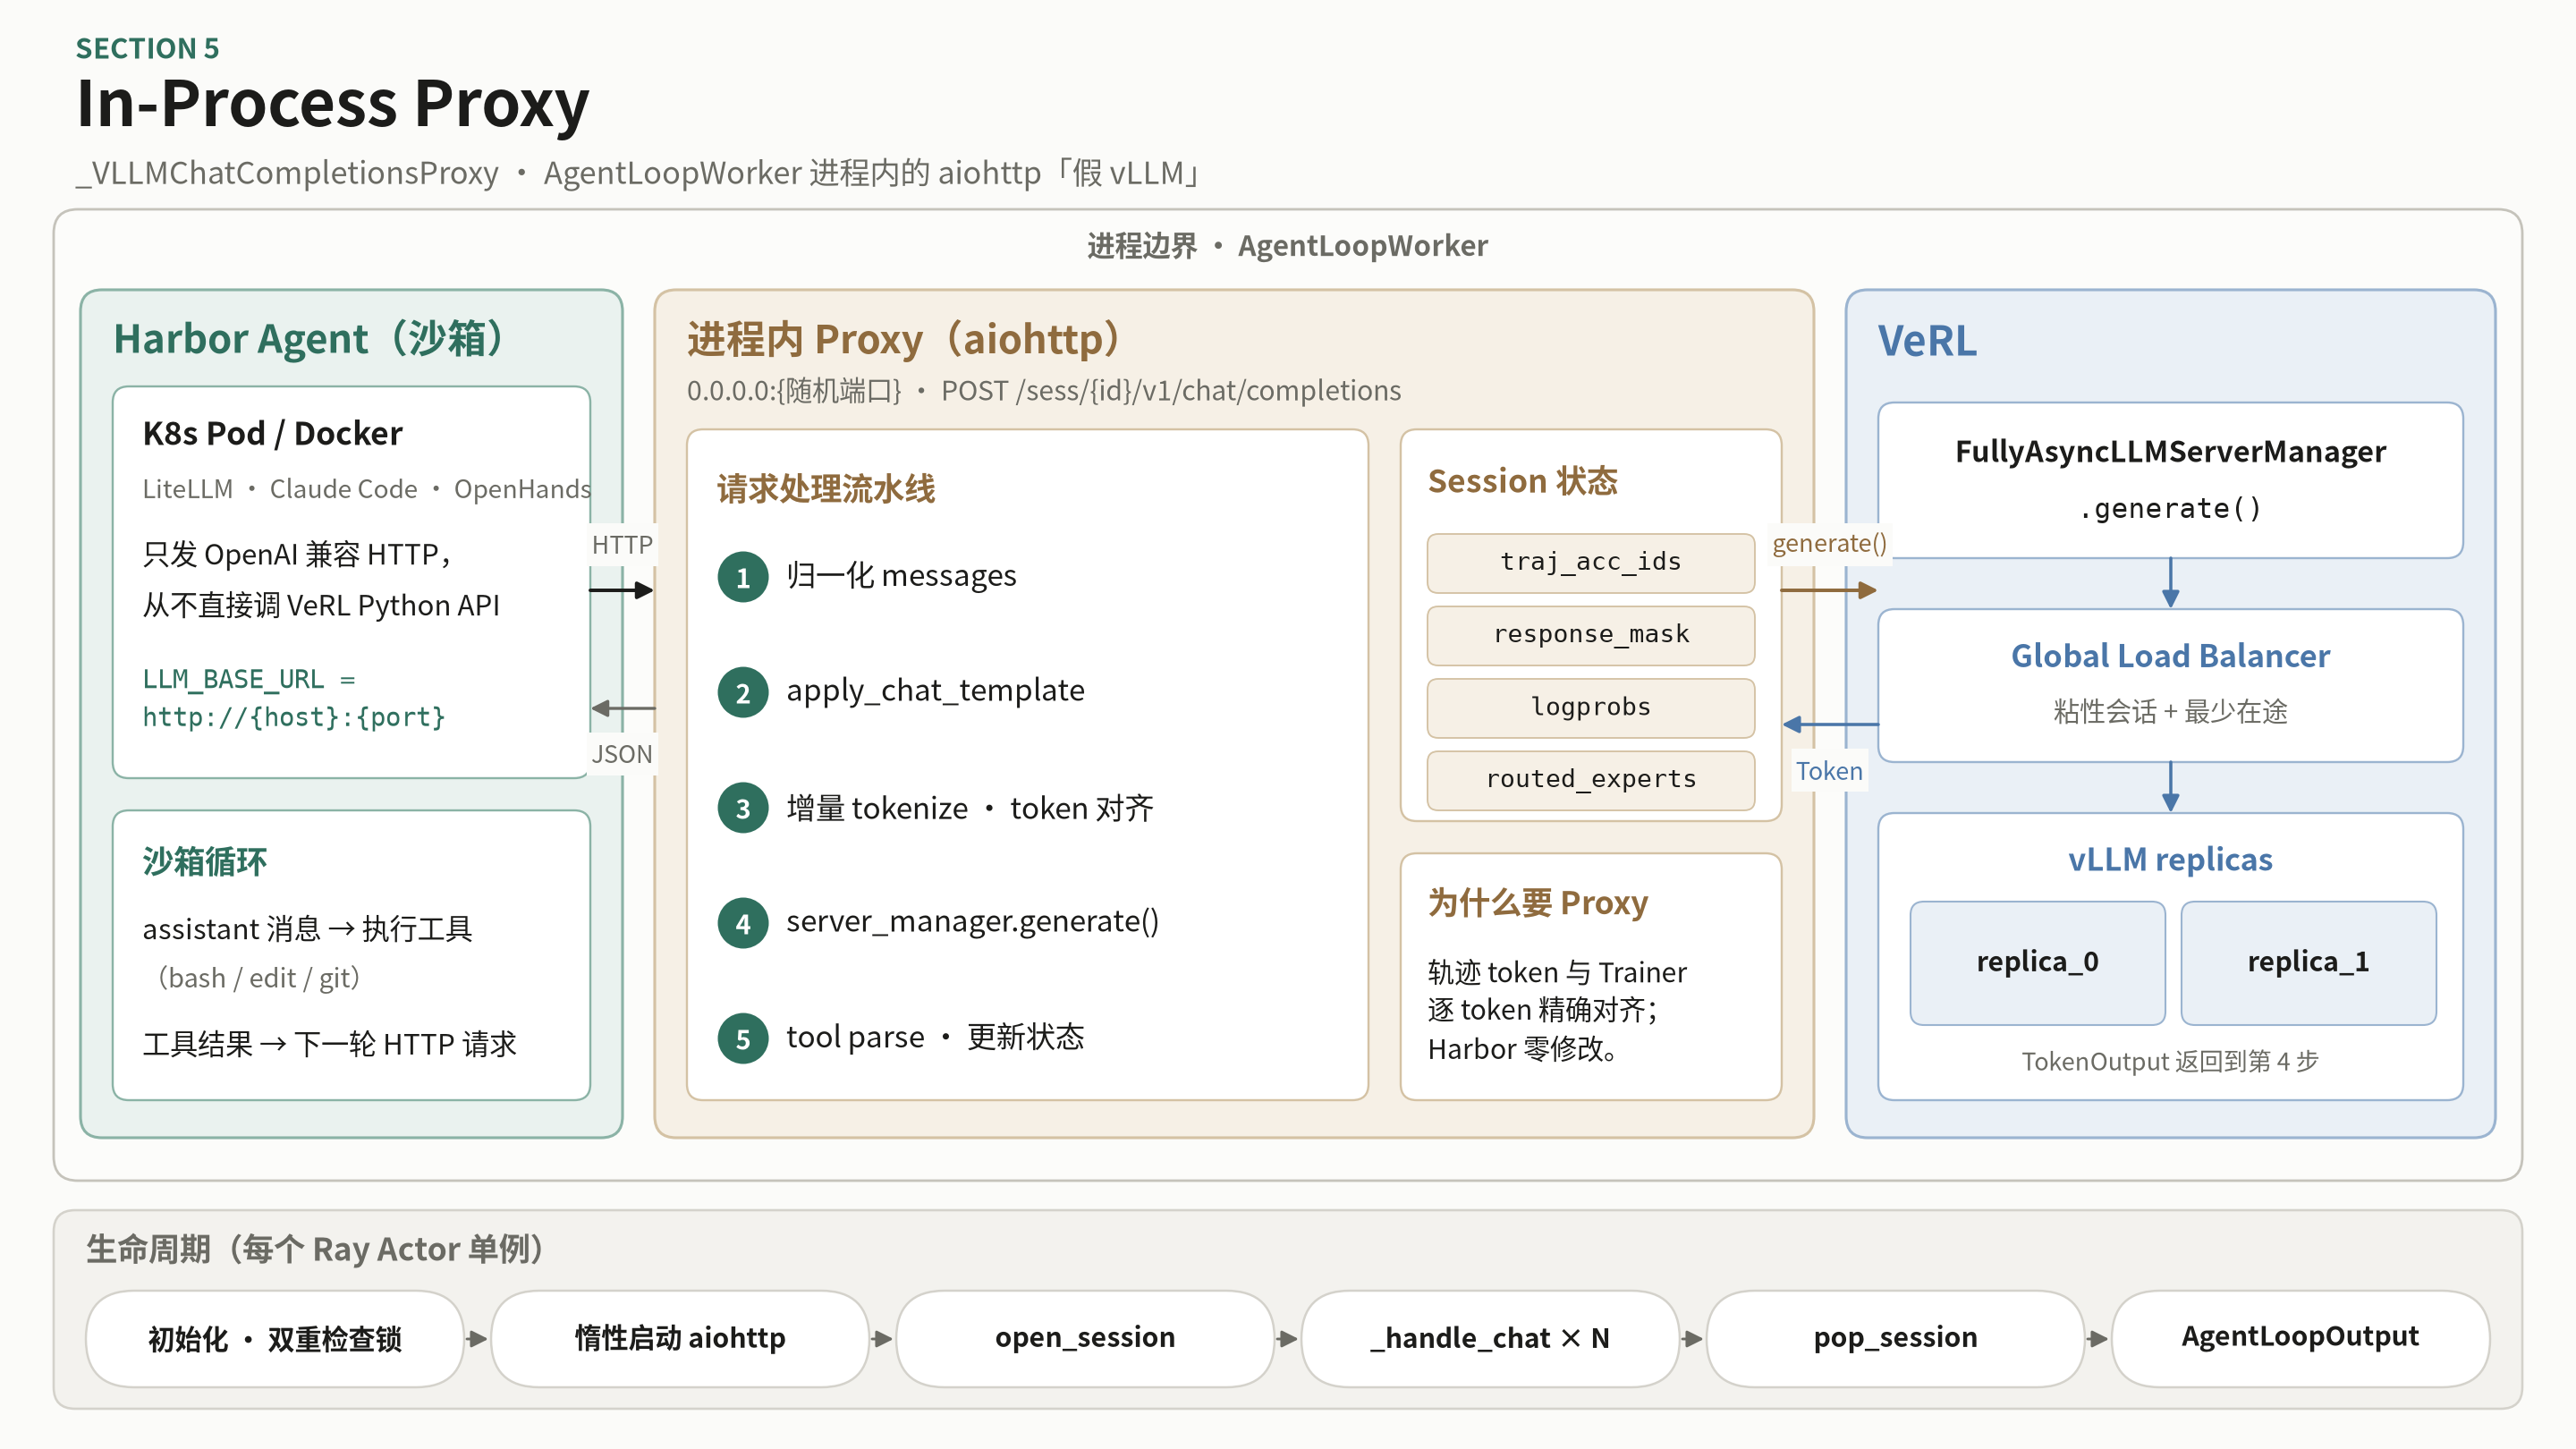 In-Process Proxy 架构。进程内 aiohttp 伪装成 OpenAI 兼容 vLLM,做 token-in / token-out 与轨迹捕获。点击可打开原图。
┌─────────────────────────────── 进程边界 ───────────────────────────────┐
│                                                                        │
│  Harbor Agent                Proxy (aiohttp)            VeRL          │
│  (K8s Pod/Docker)          0.0.0.0:{ephemeral_port}   server_manager │
│       │                           │                          │        │
│       │  POST /sess/{id}/v1/      │                          │        │
│       │  chat/completions         │                          │        │
│       │ ────────────────────────> │                          │        │
│       │                           │  1. normalize messages   │        │
│       │                           │  2. apply_chat_template │        │
│       │                           │  3. compute prompt_ids  │        │
│       │                           │                           │        │
│       │                           │  server_manager.generate │        │
│       │                           │ ─────────────────────────>        │
│       │                           │                           │        │
│       │                           │  TokenOutput              │        │
│       │                           │ <─────────────────────────        │
│       │                           │                           │        │
│       │                           │  4. tool parse (hermes/   │        │
│       │                           │     qwen3_coder)          │        │
│       │                           │  5. update session state  │        │
│       │  OpenAI-format JSON       │                           │        │
│       │ <──────────────────────── │                           │        │
│       │                           │                           │        │
└────────────────────────────────────────────────────────────────────────┘
5.2 生命周期管理
Proxy 生命周期:

代理初始化 (per server_manager Ray Actor, 单例)
  ├── double-checked locking (threading.Lock)
  ├── 预计算 _gen_prompt_len (add_generation_prompt 的 token 数)
  ├── 预计算 _assistant_eos_tail (EOS 后的尾部 token)
  └── 创建 vLLM Tool Parser 实例

代理启动 (asyncio.Lock, 惰性启动)
  ├── 绑定 aiohttp 到 0.0.0.0:{OS 分配的端口}
  └── host IP (用于 api_base URL)

每次 Harbor Trial:
  ├── open_session(session_id, trajectory_dir)
  │   └── 初始化 session 状态 (traj_acc_ids, mask, logprobs 等)
  │
  ├── [Harbor 发送多个 HTTP 请求]
  │   └── _handle_chat() 处理每个请求
  │
  └── pop_session(session_id)
      ├── 读取累积的轨迹状态
      └── 写入 proxy_trajectory.json (用于调试)
5.3 Token-in-Token-out 保证
"Token-in-Token-out" 是 Proxy 最关键的保证——即增量式 tokenization 的结果必须与一次性 apply_chat_template 的结果逐 token 一致。这是因为 VeRL Trainer 需要精确知道每个 token 的定位。
5.3.1 正常增量路径
第 1 次请求:
  messages = [system, user]
  → apply_chat_template(all messages, tools)
  → traj_acc_ids = [token_ids]  (作为 prompt_ids)
  → initial_prompt_token_len = len(traj_acc_ids)
  → messages_snapshot = [system, user]
  → 生成完成后追加 assistant response (mask=1)

第 2 次请求:
  messages = [system, user, assistant, tool(user)]
  → messages 是 snapshot 的前缀扩展 ✓
  → delta = [tool(user)]  (只 tokenize 新增消息)
  → delta_ids = apply_chat_template(delta, remove_system_prompt=True)
  → traj_acc_ids += delta_ids  (mask=0, logprob=0.0)
  → 生成完成后追加 assistant response (mask=1)

第 3+ 次请求:
  → 同样只 tokenize delta,累积到 traj_acc_ids
5.3.2 EOS 尾部回填
vLLM 在生成 EOS token 后立即停止,不会输出 chat template 中 EOS 之后的 token(如 <|im_end|> 后面的换行符 \n)。Proxy 预计算了 assistant_eos_tail,在每次以 EOS 结束的生成后回填这些 token:
vLLM 输出: [token_1, token_2, ..., token_eos]
                                    ↑ 在此停止
chat template 完整输出: [token_1, token_2, ..., token_eos, \n]
                                                          ↑ 被省略

Proxy 回填: traj_acc_ids += [\n]  (mask=1, logprob=0.0)
5.3.3 前缀不匹配回退路径
当 Harbor Agent 修改了历史消息(不是简单追加),Proxy 会回退到逐段重建模式:
重建逻辑:
  prompt segment = apply_chat_template(prefix_msgs, tools)
  for each assistant: format(msg) 去掉头尾 gen_prompt (mask=1)
  for each non-assistant batch: apply_chat_template(batch) (mask=0)

  结果与增量路径逐 token 一致
  同时写入 debug JSON 文件用于排查
这段在解决什么
增量 tokenize 的前提坏了:不能再「只编新消息」,必须按增量路径同款切法把整段对话重新拼成一条 token 串,并且还能分出 mask=1(模型生成)和 mask=0(工具/用户观察)。
5.3.1 的增量路径在赌一件事:新请求的 messages 只是旧 messages_snapshot 的尾巴延长:
第 1 次:  [system, user]
第 2 次:  [system, user, assistant, tool]          ← 前面原封不动,只在尾巴加
第 3 次:  [system, user, assistant, tool, assistant, tool]
只要这个成立,Proxy 就只 tokenize 新增的 delta,接到 traj_acc_ids 后面。
前缀不匹配 = 新来的 messages 不是旧 snapshot 的前缀扩展(_messages_is_prefix 失败),或 tools 变了(_tools_equal 失败)。常见触发:
- Agent 做了上下文压缩,或改写了更早的 user / tool 消息
- 某条历史 assistant 被丢掉或替换。源码注释里最常见的是 abort/retry:上一轮已经生成过,Agent 侧却没把那一轮留下
- tool schema 变化
这时「只编 delta」会编错位,整条轨迹对 Trainer 就废了。
不能偷懒改成一次 apply_chat_template(全部 messages)。一次编完能得到正确的 token 串,但分不出哪些 token 是模型生成的、哪些是工具观察。PPO 需要 assistant 内容 mask=1、system / user / tool mask=0。所以必须按轮切开再拼,一边出 token、一边打 mask。这就是「逐段重建」。
Chat template 里有一块固定的「请开始当助手说话」标记,叫 gen_prompt。Qwen 一般是 3 个 token:<|im_start|>assistant\n。apply_chat_template(...) 默认会在末尾再挂一块,等模型接着写。一段真实对话在 token 线上长这样:
[system][user] <|im_start|>assistant\n     ← prompt 段,以 gen_prompt 结尾
  你好吗<|im_end|>\n                         ← 模型生成(mask=1)
[tool 结果] <|im_start|>assistant\n          ← 观察段(mask=0),末尾再挂 gen_prompt
  我去改文件<|im_end|>\n                     ← 又一轮生成(mask=1)
重建按时间顺序走三步,刻意复刻增量路径的切法:
1. prompt segment = apply_chat_template(prefix_msgs, tools)
prefix_msgs 是第一条 assistant 之前的消息(通常是 system + 第一个 user,可能带 tools 定义)。编出来的串以一块 gen_prompt 结尾。这就是 initial_prompt,对应 Trainer 里的 prompt,不算 response。
2. 每条 assistant:单独编,去掉头尾 gen_prompt(mask=1)
单独把一条 assistant 丢进 apply_chat_template,会得到:
asst_ids == <|im_start|>assistant\n + 正文 + <|im_end|>\n + <|im_start|>assistant\n
               ↑ 头:上一段末尾已经有了                    ↑ 尾:会和下一段开头撞车
头已经在上一段末尾,尾会变成「下一轮 assistant 的开头」重复一次。所以源码剥掉两端各 gp_len 个 token:
asst_ids = asst_ids[gp_len:-gp_len]
剥完只留下正文 + EOS 尾巴,打 mask=1。
3. 连续的非 assistant:整批一起编(mask=0)
中间的 user / tool 不要一条条编。增量路径本来就是 delta = 连续新增的非 assistant 一次编完。如果重建时拆开编,模板可能多插分隔符,和增量路径对不齐。所以遇到连续的 tool/user,整批一起编,得到「观察内容 + 末尾 gen_prompt」,打 mask=0。末尾那块 gen_prompt 正好当下一轮 assistant 的开头。
走完之后,token 序列和「从来没改过历史、一直走增量路径」是逐 token 相同的(再补上 5.3.2 那个 EOS 后的 \n)。
| 增量路径(历史只追加) |
回退重建(历史被改过) |
| 第 1 次:整段 prompt 一次编 |
prefix_msgs 一次编 |
| 生成后把 assistant token 接上 |
每条 assistant 单独编,剥头尾 gen_prompt |
以后只编 messages[len(snap):] |
连续非 assistant 按批编 |
回退是异常路径。Proxy 会在 trajectory_dir 写下三份 debug JSON,用来 diff 到底是哪一条被改、删、换了:
prefix_mismatch_snap_*.json:上一轮记住的 snapshotprefix_mismatch_message_*.json:这一次实际收到的 messagesprefix_mismatch_snap_debug_*.json:对照元数据
重建后 logprob 怎么处理
重建后 logprob 先填 0。如果其实是 abort/retry——新历史只是旧轨迹的前缀——公共前缀上的 logprob 仍然有效,会从旧 archive 拷回来;分叉点之后继续为 0。所以重建不等于「整条轨迹 logprob 全丢」,多数 retry 场景只丢分叉之后那截。
5.4 Rollout LogP 和 Expert Choice 传回
在 *finalize × generation() 中:
# 从 vLLM TokenOutput 提取 log_probs
lp = output.log_probs
if lp is None:
    lp = [0.0] * len(output_ids)

# 累积到 session 状态
s["traj_response_mask"] += [1] * len(output_ids)     # LLM 生成的 token
s["traj_response_logprobs"] += list(lp)              # 每个 token 的 logp

# routed_experts 在 FullyAsyncLLMServerManager 中被累积
# 用于 MoE 路由重放
if output.routed_experts is not None:
    final_output.routed_experts = torch.cat([...])
最终这些数据通过 AgentLoopOutput 传递给 Trainer:
response_logprobs → 作为 rollout_log_probs(在 bypass_mode=True 时直接用作 old_log_probs)response_mask → 区分 LLM token 和 tool tokenrouted_experts → 用于 Router Replay
5.6 独占模式下的早停机制
Proxy 支持 max_consecutive_no_tool 参数:当连续 N 个 assistant turn 都没有 tool_call 时,强制终止 session。这用于防止 Agent 进入"对话死循环"。
6VeRL 训练侧流程
6.1 FullyAsyncTrainer 整体流程
FullyAsyncTrainer 是训练的消费者,继承自 SeparateRayPPOTrainer → RayPPOTrainer。
┌─────────────────────────────────────────────────────────────┐
│                 FullyAsyncTrainer.fit()                      │
│                                                              │
│  while True:                                                 │
│    ┌──────────────────────────────────────────────────┐    │
│    │              fit_step()                           │    │
│    │                                                   │    │
│    │  1. _fit_generate                                │    │
│    │     └─ _get_samples_from_queue()                │    │
│    │        从 MessageQueue 逐个取样本                  │    │
│    │        攒够 required_samples 后 assemble batch    │    │
│    │                                                   │    │
│    │  2. _fit_compute_reward                          │    │
│    │     └─ reward_model 评分 (Harbor 已完成 reward)  │    │
│    │                                                   │    │
│    │  3. _fit_compute_log_prob                        │    │
│    │     └─ _compute_old_log_prob()                  │    │
│    │        重算 old_log_prob (含 MIS 支持)           │    │
│    │                                                   │    │
│    │  4. _fit_compute_ref_log_prob                    │    │
│    │     └─ Reference Policy 的 log prob              │    │
│    │                                                   │    │
│    │  5. _fit_compute_critic                          │    │
│    │     └─ Critic 模型估值                            │    │
│    │                                                   │    │
│    │  6. _fit_compute_advantage                       │    │
│    │     └─ GAE 优势函数计算                           │    │
│    │                                                   │    │
│    │  7. _fit_update_critic                           │    │
│    │     └─ Critic 参数更新                            │    │
│    │                                                   │    │
│    │  8. _fit_update_actor                            │    │
│    │     └─ Actor PPO/GRPO/DAPO loss 更新             │    │
│    │                                                   │    │
│    │  9. _fit_update_local_step                       │    │
│    │     └─ local_trigger_step 递增                    │    │
│    │        达到 trigger_parameter_sync_step 则复位     │    │
│    │                                                   │    │
│    │  10. _fit_update_weights                         │    │
│    │     └─ 若 local_trigger_step==1:                │    │
│    │        → checkpoint_manager.update_weights()    │    │
│    │        → rollouter.reset_staleness()            │    │
│    └──────────────────────────────────────────────────┘    │
│    if TrainingStopException: break                          │
└─────────────────────────────────────────────────────────────┘
6.2 样本获取流程
async def _get_samples_from_queue(self):
    """从 MessageQueue 逐个取样本,攒够 required_samples 个"""
    samples = []
    for _ in range(self.required_samples):
        raw_sample = await self.message_queue_client.get_sample()
        if raw_sample is None:  # 终止信号
            break
        rollout_sample = ray.cloudpickle.loads(raw_sample)
        samples.append(rollout_sample)

    # 组装成 DataProto batch
    batch = assemble_batch_from_rollout_samples(samples)
    return batch
6.4 Rollout Importance Sampling (IS) 与 bypass_mode
bypass_mode = True (默认):
  old_log_probs = rollout_log_probs  (零额外计算)

bypass_mode = False:
  old_log_probs = 用训练引擎 (FSDP/Megatron) 重新计算
  同时启用 Rollout IS 修正 (compute_rollout_correction_weights)
  等价于 AReaL 的 Decoupled PPO
6.5 local_trigger_step 与参数同步时机
local_trigger_step 计数器逻辑:

fit_step 1  → local_trigger_step = 1 → 触发 weight sync + reset_staleness
fit_step 2  → local_trigger_step = 2
fit_step 3  → local_trigger_step = 3
...
fit_step N  → local_trigger_step = trigger_parameter_sync_step
            → 下次复位为 1 并 current_param_version += 1
这种设计实现了"多步本地训练 + 一次参数同步"的 off-policy pipeline。
7权重同步整体流程与 Partial Rollout
7.1 权重同步完整流程
CheckpointEngineManager.update_weights() 是权重同步的核心入口:
┌─────────────────────────────────────────────────────────────────┐
│          CheckpointEngineManager.update_weights()                │
│                                                                  │
│  Step 1: Abort all in-flight requests                           │
│    └─ 对每个 Rollout Replica 调用 replica.abort_all_requests()  │
│       → vLLM 收到 abort 信号,当前推理终止                        │
│       → TokenOutput.stop_reason = "aborted"                     │
│                                                                  │
│  Step 2: 构建临时 RayWorkerGroup                                │
│    └─ 收集所有 Rollout Replica 的 workers                        │
│                                                                  │
│  Step 3: Sleep replicas (可选,free_cache_engine)               │
│    └─ 释放 vLLM KV-cache GPU 显存                                │
│       → 为 NCCL 权重传输释放更多的 GPU 显存空间                   │
│                                                                  │
│  Step 4: 构建 NCCL Process Group                               │
│    └─ Trainer rank 0 + 所有 Rollout workers                     │
│       → 跨进程的 NCCL 通信域                                     │
│                                                                  │
│  Step 5: 权重传输                                               │
│    ├─ Trainer rank 0: send_weights()                           │
│    │   ├─ 遍历模型 weight generator                            │
│    │   ├─ 将参数 pack 到 CuPy send buffer (双缓冲)              │
│    │   └─ 通过 NCCL Broadcast 发送                              │
│    │                                                             │
│    ├─ Rollout workers: receive_weights()                       │
│    │   ├─ 通过 NCCL Broadcast 接收                              │
│    │   ├─ 接收 ZMQ PUB/SUB 元数据 (tensor name, shape, offset) │
│    │   └─ Unpack 到目标 tensor                                  │
│    │                                                             │
│    └─ ZeroMQ PUB/SUB 与 NCCL 并行传输元数据                     │
│                                                                  │
│  Step 6: Finalize                                               │
│    └─ 释放 NCCL bucket, 销毁 process group (可选)                │
│                                                                  │
│  Step 7: Wake up replicas                                       │
│    └─ 恢复 vLLM KV-cache, 重新加载权重到 GPU                     │
│                                                                  │
│  Step 8: Resume unfinished requests (Partial Rollout)          │
│    └─ 对每个 Replica 调用 replica.resume_generation()          │
│       → 中断的样本从中断点继续生成                                │
└─────────────────────────────────────────────────────────────────┘
7.2 Partial Rollout 机制详解
无 Partial · 等全部跑完
|-- 样本1 --|-- 样本2 --|-- 样本3 --|-- 等待 --|-- 同步 --|-- 样本4 --|
                                      ↑
                              同步前必须清空 active_tasks
有 Partial · 切断再续写
|-- 样本1 --|-- 样本2 --|-- 样本3…中断…同步后继续…|-- 样本4 --|
                          ↑                    ↑
                   abort_all_requests()   resume_generation()
Partial Rollout 解决了权重同步时的一个关键问题:如何在不停掉进行中的样本生成的情况下完成权重同步?
7.2.1 无 Partial Rollout(staleness_threshold > 0, partial_rollout = False)
同步到来时先等待所有 active_tasks 结束,再传权重。吞吐被长尾样本拖住。
7.2.2 有 Partial Rollout(staleness_threshold > 0, partial_rollout = True)
abort_all_requests() 让当前推理以 stop_reason=aborted 结束;同步完成后 resume_generation() 从中断点继续,对 Agent Loop 仍是一次 generate()。
7.2.3 FullyAsyncLLMServerManager 的中断恢复实现
class FullyAsyncLLMServerManager:
    async def generate(self, ...):
        final_output = TokenOutput(token_ids=[], ...)

        while True:
            # 每次迭代传入 prompt_ids + 已生成的 tokens
            output = await super().generate(
                prompt_ids=prompt_ids + final_output.token_ids,
                ...
            )

            # 累积到 final_output
            final_output.token_ids.extend(output.token_ids)
            final_output.log_probs.extend(output.log_probs)

            # 检查是否需要继续(中断恢复)
            if output.stop_reason in ("aborted", "abort") \
               and partial_rollout is True:
                continue  # 继续循环,从中断点重新生成
            else:
                break  # 正常完成,退出循环

        return final_output
关键点:
- 对 ToolAgentLoop/BuiltinSWEAgentLoop 完全透明——它们只看到一个
generate() 调用
FullyAsyncLLMServerManager 内部处理跨权重版本的中断恢复- 通过
min_global_steps / max_global_steps 记录轨迹跨越的权重版本范围
7.3 权重同步时序图
Trainer                        ParameterSynchronizer           Rollouter/Replicas
  │                                    │                            │
  │ _fit_update_weights()              │                            │
  │  (local_trigger_step == 1)         │                            │
  │───────────────────────────────────>│                            │
  │                                    │ abort_all_requests()       │
  │                                    │───────────────────────────>│
  │                                    │                            │ 正在生成的请求
  │                                    │                            │ 收到 abort 信号
  │                                    │                            │ stop_reason="aborted"
  │                                    │                            │
  │                                    │ sleep_replicas()           │
  │                                    │───────────────────────────>│ 释放 KV-cache
  │                                    │                            │
  │                                    │ build NCCL process group   │
  │                                    │<─ Trainer + Replicas ─────>│
  │                                    │                            │
  │ send_weights()                     │                            │
  │ (NCCL Broadcast)                   │                            │
  │════════════════════════════════════════════════════════════════>│ receive_weights()
  │                                    │                            │
  │                                    │ wake_up_replicas()         │
  │                                    │───────────────────────────>│ 恢复 KV-cache
  │                                    │                            │
  │                                    │ resume_generation()        │
  │                                    │───────────────────────────>│ 继续未完成的请求
  │                                    │                            │
  │ rollouter.reset_staleness()        │                            │
  │────────────────────────────────────────────────────────────────>│
  │                                    │                            │ paused=False
  │                                    │                            │ staleness_samples=len(active_tasks)
7.5 Reset Staleness 逻辑
同步完成后,Trainer 调用 rollouter.reset_staleness():
async def reset_staleness(self):
    async with self.lock:
        # 将在途任务数 + 队列中等待的样本数 设为新的 staleness 基准
        self.staleness_samples = len(self.active_tasks) + self.pending_queue.qsize()

        # 解除暂停信号
        self.paused = False
        self._resume_event.set()

        # 记录 idle/active 时间用于计算 idle_ratio
这样设计的原因:staleness_samples 需要反映"在当前参数版本之后生成的样本数"。reset 后,已有的 active_tasks 和 pending 样本都算作新版本下的样本。
A完整链路流程总图
以下是 fully_async_2nodes.sh 启动后的完整数据流:
                           ┌───────────────────┐
                           │  fully_async_main   │  (Hydra 入口)
                           │   (FullyAsyncTaskRunner) │
                           └─────────┬─────────┘
                                     │
                     创建 MessageQueue, FullyAsyncTrainer, FullyAsyncRollouter
                     初始参数同步, Trainer ← NCCL → Rollouter
                                     │
              ┌──────────────────────┼──────────────────────┐
              ▼                      ▼                      ▼
    ┌─────────────────┐   ┌──────────────┐   ┌─────────────────────┐
    │ FullyAsyncTrainer │   │ MessageQueue  │   │ FullyAsyncRollouter │
    │   (1 node, 8 GPU)  │   │  (Ray Actor)  │   │   (1 node, 8 GPU)   │
    └────────┬────────┘   └──────┬───────┘   └──────────┬──────────┘
             │                   │                       │
             │   get_sample()    │      put_sample()     │
             │<──────────────────│<──────────────────────│
             │                   │                       │
    ┌────────▼────────┐          │              ┌────────▼──────────┐
    │ PPO Training     │          │              │ _feed_samples()   │
    │ 1. get samples   │          │              │  从 dataloader     │
    │ 2. reward        │          │              │  逐条读取任务       │
    │ 3. old_log_prob  │          │              │  → pending_queue   │
    │    (MIS支持)     │          │              └────────┬──────────┘
    │ 4. ref_log_prob  │          │                       │
    │ 5. critic        │          │              ┌────────▼──────────┐
    │ 6. advantage     │          │              │ _processor_worker()│
    │ 7. update critic │          │              │  逐个处理样本       │
    │ 8. update actor  │          │              │  max_concurrent     │
    │                  │          │              │  控制并发数         │
    │ sync_weights()──>│          │              └────────┬──────────┘
    │                  │          │                       │
    │                  │          │        ┌──────────────▼──────────────┐
    │                  │          │        │ _process_single_sample()    │
    │                  │          │        │   → async_rollout_manager   │
    │                  │          │        │     .generate_sequences_    │
    │                  │          │        │     single()                │
    │                  │          │        └──────────────┬──────────────┘
    │                  │          │                       │
    │                  │          │        ┌──────────────▼──────────────┐
    │                  │          │        │ FullyAsyncAgentLoopManager  │
    │                  │          │        │   → Worker Queue            │
    │                  │          │        │   → BuiltinSWEAgentLoop     │
    │                  │          │        │     .run()                  │
    │                  │          │        └──────────────┬──────────────┘
    │                  │          │                       │
    │                  │          │        ┌──────────────▼──────────────┐
    │                  │          │        │ Harbor Trial.run()          │
    │                  │          │        │  ├─ env_setup (K8s Pod)     │
    │                  │          │        │  ├─ agent_setup             │
    │                  │          │        │  ├─ agent_execute loop:    │
    │                  │          │        │  │   ├─ HTTP → Proxy        │
    │                  │          │        │  │   │  → _handle_chat()   │
    │                  │          │        │  │   │  → server_manager   │
    │                  │          │        │  │   │    .generate()      │
    │                  │          │        │  │   │  → (FullyAsync)     │
    │                  │          │        │  │   └─ tool_execute       │
    │                  │          │        │  └─ verify                 │
    │                  │          │        └─────────────────────────────┘
    │                  │          │
    │<── AgentLoopOutput ─────────┘  (经 MessageQueue 传递)
    │    prompt_ids, response_ids,
    │    response_mask, response_logprobs,
    │    reward_score, num_turns,
    │    min_global_steps, max_global_steps
B关键文件索引
| 文件 |
作用 |
| fully_async.md |
全异步训练官方文档 |
| fully_async_2nodes.sh |
2 节点全异步启动脚本 |
| fully_async_main.py |
全异步入口,FullyAsyncTaskRunner 编排 |
| fully_async_trainer.py |
FullyAsyncTrainer:训练消费端 |
| fully_async_rollouter.py |
FullyAsyncRollouter:样本生产端 |
| message_queue.py |
MessageQueue + MessageQueueClient |
| agent_loop.py |
AgentLoopBase + AgentLoopWorker + AgentLoopManager |
| tool_agent_loop.py |
ToolAgentLoop 状态机实现 |
| agent_loop.py (async) |
FullyAsyncLLMServerManager + FullyAsyncAgentLoopManager |
| base.py |
CheckpointEngineManager:权重同步编排 |
| nccl_checkpoint_engine.py |
NCCLCheckpointEngine:NCCL 权重传输 |
| builtin_swe_agent_loop.py |
Harbor SWE Agent Loop 适配 |
| vllm_chat_completion_proxy.py |
进程内 vLLM HTTP Proxy |
| harbor_verl_fully_async_fsdp.yaml |
全异步 FSDP 训练配置 |
C术语表
| 术语 |
解释 |
| Colocate |
训推一体架构,Rollout 和 Training 共享同一组 GPU |
| Fully Async |
全异步训推分离架构,Rollouter 和 Trainer 完全解耦 |
| Rollouter |
样本生成器,持续异步地产生训练样本 |
| MessageQueue |
基于 Ray Actor 的异步消息队列,连接 Rollouter 和 Trainer |
| Staleness |
陈旧度,指样本生成时所用参数与当前训练参数之间的版本差异 |
| Partial Rollout |
中断恢复机制,权重同步时暂停进行中的 rollout,同步后从中断点继续 |
| MIS |
Multiple Importance Sampling,多步重要性采样,保证 pi_old 一致性 |
| bypass_mode |
直接使用 rollout_log_probs 作为 old_log_probs,省去重算 |
| Token-in-Token-out |
增量式 tokenization 与一次性 tokenization 结果逐 token 一致 |
| Router Replay |
MoE 路由器决策的复现能力,需要记录 routed_experts 和 global_steps |
| Proxy |
进程内 HTTP Server,将 Harbor 的 OpenAI 格式请求转发到 VeRL 的 server_manager |
| AgentLoop |
VeRL 中封装单条轨迹生成逻辑的抽象单元 |
| checkpoint-engine |
基于 NCCL 的高效分布式参数同步引擎 |